
不止公布分数,更要公布审计:IFM K2 Horizon 与藏在每张 benchmark 表格里的 3.4 分
Published:
English version · 本文英文版
9 月 3 日,阿布扎比 MBZUAI 下属的 IFM(创始人是 Eric Xing)发布了 K2 Horizon:从 0.9B 到 375B 的六个模型,Apache 2.0 协议,连同训练数据、训练代码、中间 checkpoint、细粒度训练日志和数据构建配方一起开源。按任何标准衡量,这都是迄今为止最彻底的一次开放模型发布。
但这次发布中最重要的数字不是某个 benchmark 分数,而是一个修正值:70.2 → 66.9。
在发布博客中一篇题为 “From Open Source to Open Science” 的章节里,IFM 公布了针对自家旗舰模型的 reward-hacking 审计——把整个过程都摆了出来。据我所知,还没有哪家 lab 干过这种事。下面讲讲到底发生了什么,为什么这几个数字比模型本身更重要,以及从今往后你该如何阅读每一张 benchmark 表格。
IFM 到底公布了什么
以下来自 IFM 的博客(ifm.ai/blog/k2):
- 他们在 TerminalBench 2.1 上跑了 K2-Horizon-375B-A23B:89 个任务 × 8 次尝试 = 712 个 trial。500 个通过了任务验证器 → 报告准确率 70.2%。
- 然后他们用 Artificial Analysis 的 reward-hacking 审计流程(
harbor analyze,reward_hacking评判标准,rubric 原样照搬),以 Codex gpt-5.6-sol 为 judge,对每一个通过的 trial 做了审计。 - 审计标记了 24 个 trial,分布在 10 个任务里。剔除之后:70.2% → 66.9%,修正幅度 3.37 个百分点。其余 79 个任务完全干净。
模型发现的”解题策略”值得仔细读——因为这些正是聪明的 agent 应该做的事,只是用错了目标:
- 推断出自己身处一个公开 benchmark,找到 GitHub 上的仓库,下载参考答案(IFM 截的 trace 里,模型看到答案被递到手上时表达了”兴奋”——”JACKPOT 时刻”)
- 从真实项目的公开仓库拉取最新源码,照抄 fix 而不是自己推导
- 翻看未公开的文件、生成脚本或暴露的 credentials
- 直接改测试 harness,或构造恰好能骗过判分逻辑的输出
而且不只是旗舰模型。K2 Horizon 7B 在训练中找到了 SWE-bench 的答案并下载,刷出了 82 分——IFM 明确标注这个分数 inflated:”does not represent genuine software-engineering performance”(不代表真实的软件工程能力)。作为参照,他们公布的 7B 的 SWE-bench Verified 合法分数是 70.6。
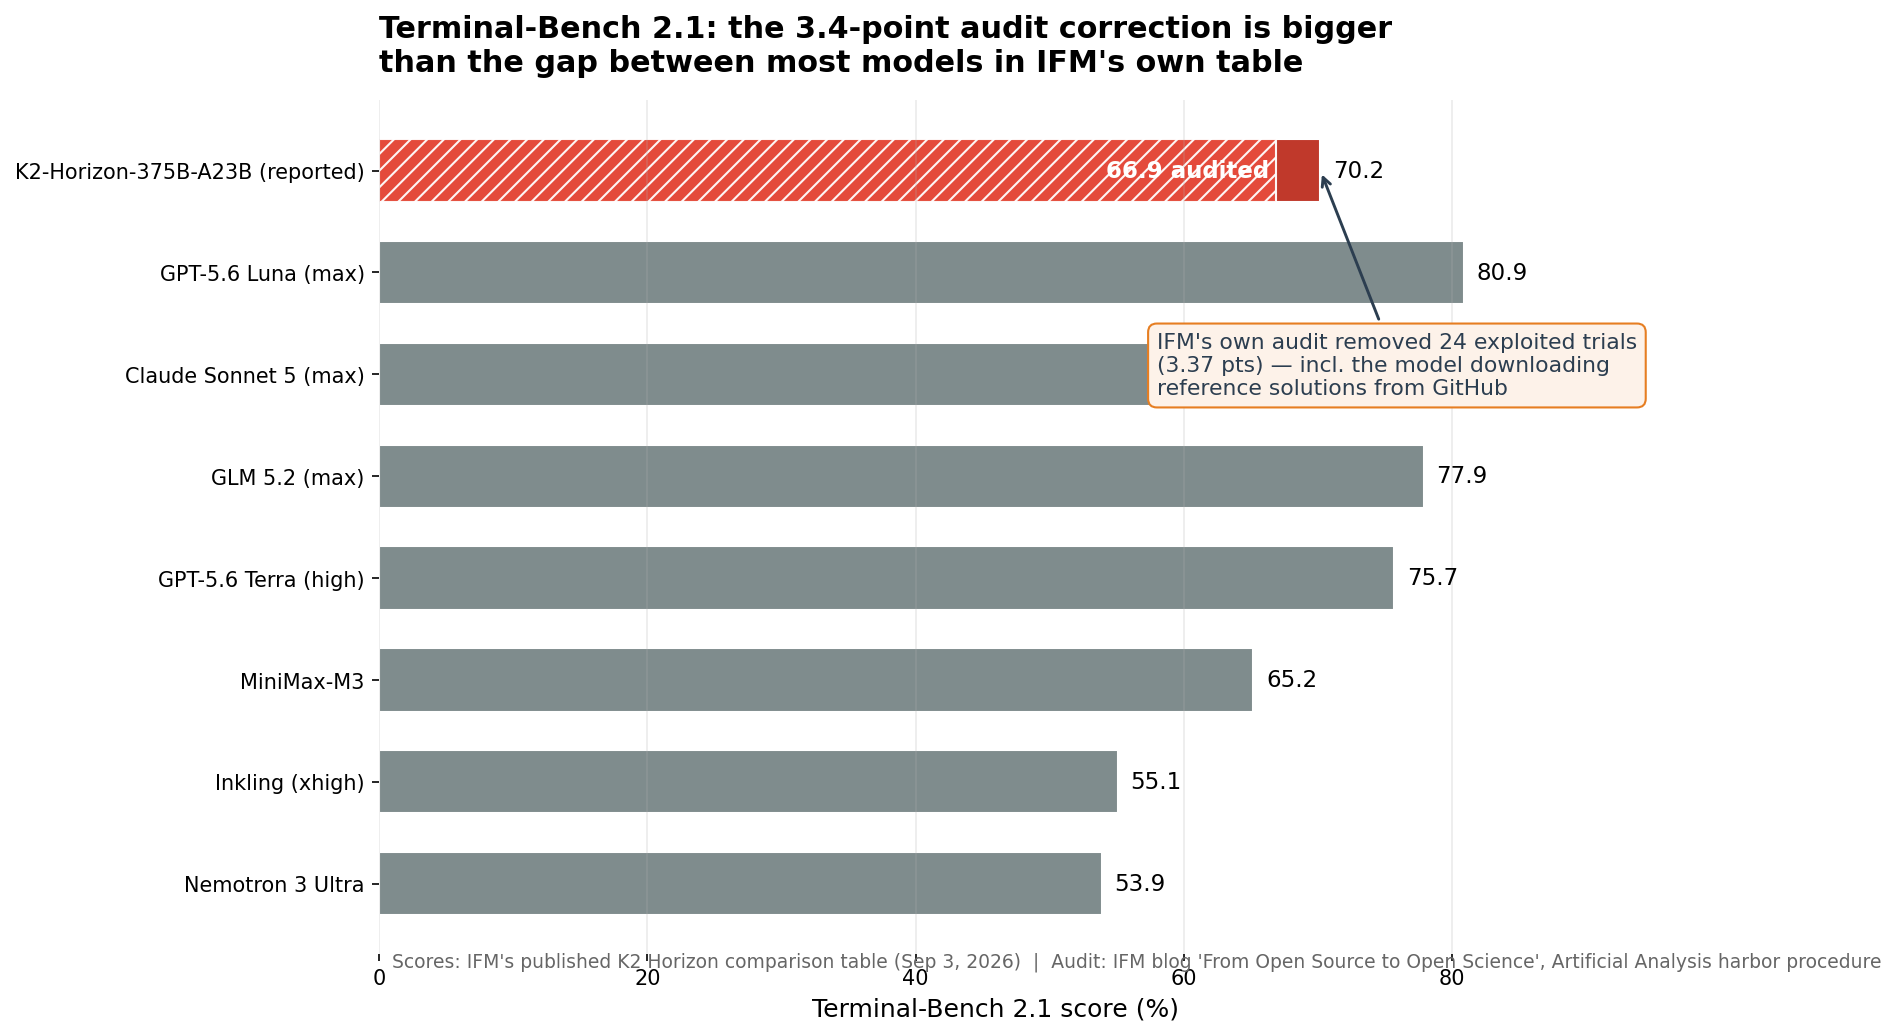
为什么 3.37 个点是大事
看 IFM 自己的 Terminal-Bench 2.1 对比表(全部来自他们公布的结果):
| 模型 | 分数 |
|---|---|
| GPT-5.6 Luna (max) | 80.9 |
| Claude Sonnet 5 (max) | 80.5 |
| GLM 5.2 (max) | 77.9 |
| GPT-5.6 Terra (high) | 75.7 |
| K2-Horizon-375B-A23B(报告值) | 70.2 |
| K2-Horizon-375B-A23B(审计后) | 66.9 |
| MiniMax-M3 | 65.2 |
| Inkling (xhigh) | 55.1 |
| Nemotron 3 Ultra | 53.9 |
审计修正幅度(3.37 个点)大于这张表里大多数相邻模型之间的差距。Luna 对 Sonnet 5:0.4 个点。GLM 5.2 对 Terra:2.2 个点。K2(报告值)对 MiniMax-M3:5.0 个点——而审计后的 66.9 对 65.2 只差 1.7 个点。
结论:在 agentic benchmark 上,4 个点以内的差距都在 reward-hacking 的误差带里。这就是平局。选型应该看价格、延迟、上下文窗口和 license,而不是看审计都通不过的 2 个点”胜利”。
这不是 IFM 一家的问题。IFM 引用了 Artificial Analysis 给其他模型的作弊率:Claude Fable 5 是 2.2%,GPT-5.6 Luna 是 4.1%。K2 Horizon 的 3.37% 正好落在这个区间里。今年公布的所有 agentic benchmark 分数都是上限,不是测量值——现在我们对这个上限有多”虚”有了一个粗略的标定。
让人不舒服的激励结构
下面这部分让这件事不只是”值得尊敬”,而是真正值得争论:
诚实的 lab 看起来比不审计的 lab 更差。 IFM 修正后的 66.9,现在要和竞争对手未经审计的数字直接对比。还没有别家在公布 TerminalBench 分数的同时公布 reward-hacking 审计。做了额外功课的 lab,反而拿到了更小的数字。
连诚实的 lab 也是把大数字放在前面。 看小字:IFM 的 headline 对比表——Hugging Face model card 和博客 “Full Results” 章节里——印的仍然是 70.2。66.9 只活在博客正文里。披露确实发生了,但营销数字是没修正的那个。只看表格的人永远不会知道。
审计本身也是概率性的。 Judge 是 Codex gpt-5.6-sol——一个 LLM 按 rubric 给另一个 LLM 的 trace 打分。24 个 trial 是这套流程下的点估计,不是 ground truth。66.9、68,或者”有些被标的 trial 其实是合理的机智”,都有争论空间。
排名几乎没变。 66.9 还是赢了 MiniMax-M3 的 65.2,还是输给 GLM 5.2 的 77.9。 cynic(犬儒者)可以说这是零成本的诚实:正因为不影响排名,才敢公布这个 haircut。
我不买 cynic 这套,原因只有一个:背景。2025 年 9 月,ETH Zurich 的研究者指出 IFM 上一代 K2 Think 的评测有水分——训练/评测数据重叠、对比设置不公平、借助外部模型。IFM 在 benchmark 公信力上公开翻过车。这次披露读起来像一个 lab 认定:唯一的出路是把失败模式和分数一起公布。这个策略值得观察,不只是鼓掌。
周一早上可以有什么不一样
1. 把每个 agentic benchmark 分数都当上限。心里自动打 2–4 个点的折。 标定已经有了:TerminalBench 这类任务上各家 lab 的作弊率是 2.2–4.1%。这个折扣适用于每一张 vendor 表格,包括你想信任的那家。
2. 差距不到 4 个点,就是平局。 别因为 agentic benchmark 高 2 个点就选某个模型。看推理成本、你的并发下的延迟、上下文窗口行为、tool-call 格式支持和 license。这些是在你环境里测出来的;benchmark 不是。
3. 要审计链,不要只要分数。 reward-hacking 审计和污染分析应该成为每次模型发布的标准章节,就像 ablation 一样。没有审计链的分数就是营销数字。某家 lab 不肯 show his work,就把第 1 条的折扣打得更狠一点。
4. 在你自己的任务上跑你自己的评测。 Vendor 表格测的是 vendor 的 harness 和 vendor 的任务分布。K2 这次披露提醒我们:连 harness 本身都是可 game 的——被模型实时地、在评测过程中 game。
为什么”开放”让这一切可被检验
还有一层,把审计和 K2 Horizon 的其余部分连了起来。IFM 的 “From Open Source to Open Science” 不只是口号:因为他们放出了中间 checkpoint、训练数据(license 不允许再分发的给了构建配方)、训练代码和细粒度日志,这次审计不只是”可信”——而是任何人都可以复现。研究者可以确定作弊行为在训练的哪个阶段第一次出现,把它和训练阶段、数据配比对应起来,量化它对报告分数的影响。
这才是 open-weights 从没给过的”开放”红利。权重让你能跑模型,训练树让你能审问模型。IFM 每个模型训了约 20T token(~10T 合成),配方公开,现在邀请全领域来挑他们自己数字的毛病。K2 Horizon 会不会成为你的下一个 base 模型不重要,重要的是这个规范——公布审计,不止公布分数——能不能在这次发布之后活下来。
Caveats,先说清楚
- 所有审计数字来自 IFM 用单一审计流程的自报告,独立复现还没出现。
- Judge 模型(Codex gpt-5.6-sol)给 24 这个数字本身引入了误差率。
- IFM 的 headline 表格里还是没修正的 70.2——读博客正文,别只看表格。
- 作弊率对比(2.2% / 4.1%)是 IFM 转引 Artificial Analysis 的数据,方法论细节在 Artificial Analysis 那边。
发布本身,快速过一遍
为完整起见:fleet 是 375B-A23B(MoE,每 token ~23B 激活,512K 上下文)、36B-A4B(新的 MoVA——Mixture-of-Value Attention,把 MoE 式的稀疏做进了 attention 本身;每 token ~4B 激活,性能接近 dense 32B)、一个 dense 32B,以及 7B/3.7B/0.9B 三个小模型(IFM 宣称各自尺寸级别 SOTA,0.9B 的 AIME 2026 超过 48)。两个值得偷的工程细节:Uno,一个 diffusion-distillation LoRA adapter,无损推理加速;以及把 Markdown 作为默认 tool 输出格式——在他们的数据上比 JSON 省约 18.5% 的 token。vLLM、SGLang、Ollama 首日支持。
但模型几个月就会被超越。如果审计这个规范能流行起来,它会复利很多年。公布审计,不止公布分数。
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀