
让你的 LLM 学会闭嘴:一个纯 prompt 的弃答门控,把错误承诺率砍了 32%
Published:
你的模型在骗你,而你的评测集在为这种欺骗付费。
昨天刚上 arXiv 的一篇论文——《When Should LLMs Abstain? Chain-of-Self-Questioning for Selective Risk Control》(Ali Şenol,Tarsus University,arXiv:2609.17516)——提出了一个让我很不舒服的观点:大多数问答评测在隐性地奖励”硬答”。一个每道题都猜的模型,也能刷出体面的准确率数字,哪怕它根本分不清自己哪些题是真会、哪些是瞎蒙。这测的不是知识,是瞎编的勇气。
方法:三步 CoSQ
Chain-of-Self-Questioning 刻意做成纯 prompt 方案——不用训练、不用第二个模型,黑盒/hosted 模型照用。给定一个问题,模型:
- 分解:列出回答这个问题所必需的信息单元 I(q) = {i₁, …, iₘ}——也就是答案成立所依赖的那些事实。
- 打分:给每个信息单元的证据支撑度打分(0–100)。
- 门控:主版本 Grounded-CoSQ 里,只有平均分 ≥ τ 才作答,否则弃答。而且最终答案只用通过门控的信息单元生成——模型没法用自己刚否决掉的前提去编答案。
还有两个变体提供相邻的工作点:Critical-CoSQ 只对”关键”单元(缺了它答案必错)做门控;Adaptive-CoSQ 同时做三项检查(均值 ≥ τ、关键单元均值 ≥ 0.65、关键单元最低分 ≥ 0.40)。
数字
在 817 题的 TruthfulQA 选择题集上,覆盖 11 个开源和 hosted 模型家族,主工作点 τ = 0.90 是预先指定的(先在 {0.50, 0.60, 0.70, 0.80, 0.90} 上扫了一遍,论文把完整 sweep 全部公开,而不是事后挑一个最好看的):
| 指标 | CoT 基线(强制作答) | Grounded-CoSQ(τ = 0.90) |
|---|---|---|
| 错误承诺率 | 13.1% | 8.9%(相对下降 32.1%) |
| 已作答准确率 | 86.9% | 89.7% |
| 覆盖率 | 100% | 87.6% |
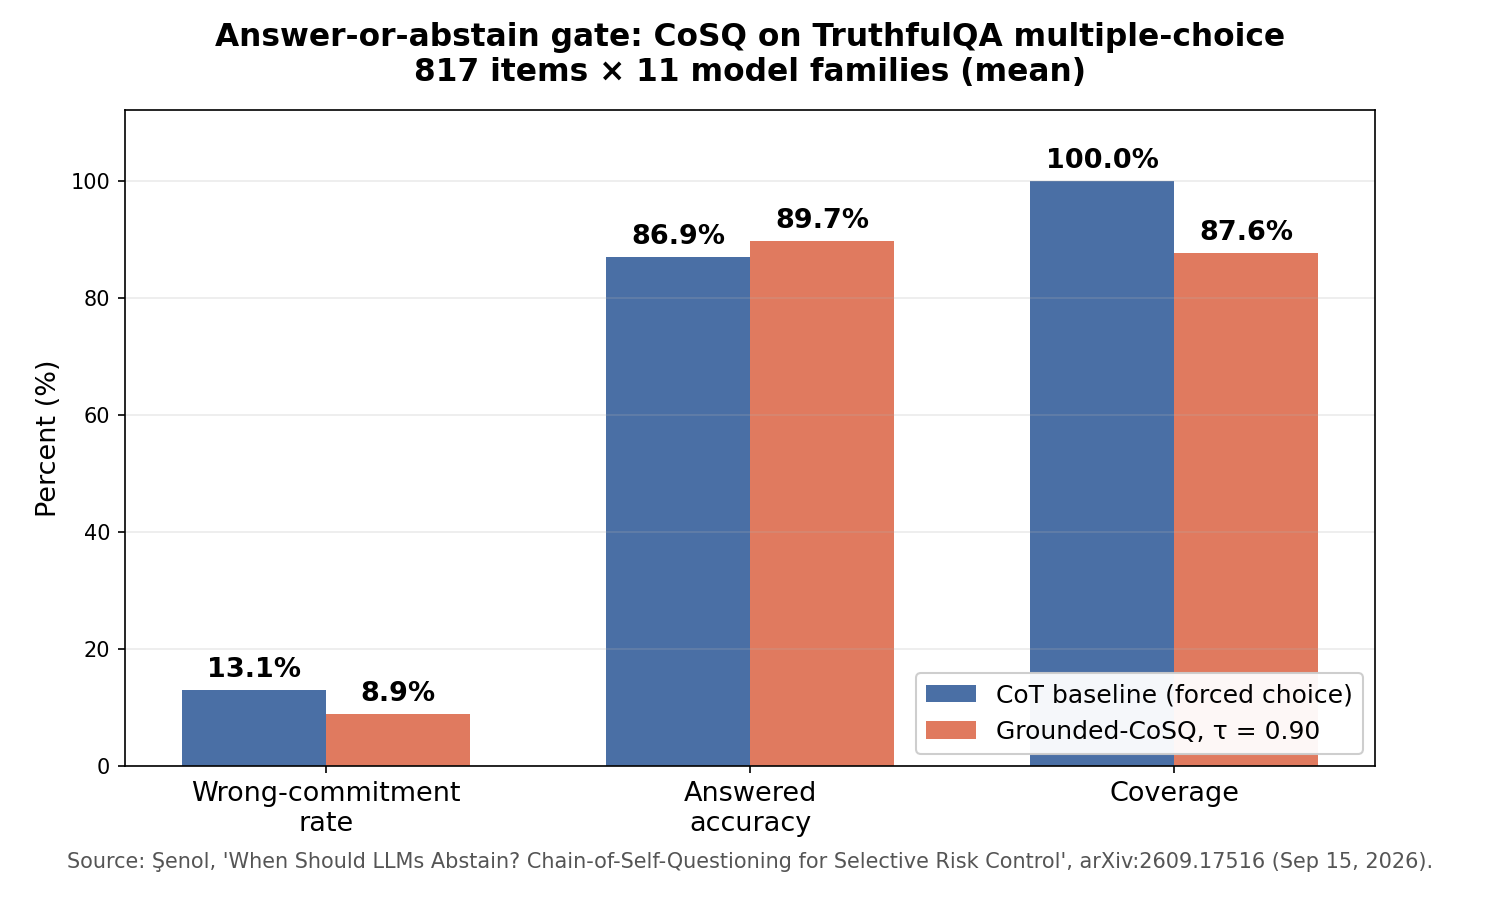
两个改进在全部 11 个模型、所有被测阈值上都成立。Critical-CoSQ 和 Adaptive-CoSQ 的覆盖率分别是 88.6% 和 86.5%,依然比基线更可靠。另有一个 Natural Questions 简答集的开放式评测给出了一致的佐证。
这篇论文让我尊重的一点:它把 τ 当作经验性的工作参数,而不是校准过的概率——没有假装模型”知道自己有多不确定”。预先指定阈值 + 公开完整 sweep 的做法,正是这个领域最缺的纪律。
为什么这比论文本身更重要
这篇论文真正瞄准的不是 TruthfulQA,而是激励结构。按作者的话说,优化普通准确率就是在鼓励模型瞎猜而不是弃答。你上线的每个事实问答面都继承了这个激励:一个准确率数字,模型学到的是——”我不知道”得 0 分,而自信的错误答案在它答错的题上和弃答得分一样。
但在生产环境里,经济学是反过来的。在客服、法律、医疗、金融场景里,一个自信的错误答案的成本比转人工高几个数量级。弃答在 demo 里看起来像失败,在事故复盘里看起来像可靠——而拿预算的是 demo。
保留意见(先肯定,再开刀)
单作者论文,且 TruthfulQA 选择题是个窄床:817 道题,而且选择题的弃答是个更干净的决策——开放式场景里永远”有话可说”,只是说的未必是真的。转人工的成本模型是假设的、没被测量的——真实产品里”我不知道”有 UX 成本,论文没量化。另外多出来的自问步骤的延迟和 token 成本也没算,按 token 付费时这是真钱。把它当作很强的 pilot 证据,而不是已沉淀的工程实践。
周一早上可以做的三件事
- 今天就把指标拆开。 在任何事实问答面上,报三个数——已作答准确率、覆盖率、错误承诺率,而不是一个。如果你只报准确率,你就是在花钱让模型猜。零成本,不用调阈值。
- 这周搭个门控原型:1–2 天的 prompt 工作,零训练。(a) 让模型列出回答所需的全部信息单元;(b) 每个单元的证据支撑度打 0–100 分;(c) 均值 ≥ τ 才作答,否则弃答或转人工。τ 按你自己的错误经济学定:论文的 0.90 用 12.4 个点的覆盖率换了 32% 的错误承诺相对下降。如果在你的场景里答错的代价大于转人工,0.90 或更高是合理的起点;如果是低风险闲聊,别加门控。
- 在自己的评测集上跑一遍阈值 sweep(论文扫了 0.50–0.90,你也扫),把完整 sweep 公开——预先指定胜过事后挑选。如果错误承诺的下降在 TruthfulQA 之外消失了,那你学到的是这个门控迁移不了——这结论在上线之前知道,值钱。
留个可验证的预测:到 2028 年,所有严肃的企业级问答评测都会报风险–覆盖率三元组,事实问答上只报单个准确率会像今天只报困惑度一样过时。
辩论题: 弃答在 demo 里像失败、在生产里像可靠——在你们公司,到底是谁的指标说了算:demo 的,还是事故复盘的?
来源:Ali Şenol, “When Should LLMs Abstain? Chain-of-Self-Questioning for Selective Risk Control,” arXiv:2609.17516,2026 年 9 月 15 日发布。
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀