
DeepSeek V4.1-Flash:计费单位不再是模型,而是缓存
Published:
新闻
DeepSeek 在 9 月 10 日发布了 V4.1-Flash:552B 参数的混合专家(MoE)模型,采用因果编码器-解码器(CED)架构,100 万 token 上下文窗口,原生多模态,权重以 MIT 协议在 Hugging Face 开放。官方评测表(所有模型都在最大 reasoning effort 下跑)显示:DeepSWE v1.1 得 74.2,对 Claude Opus 5 的 74.0、GPT-5.6 Sol 的 73.0;Terminal-Bench 2.1 得 90.6,对 89.1 和 88.8;CyberGym 88.1;AutomationBench 54.8。所有数字都对照 DeepSeek 自己的技术报告和模型卡验证过,不是转述媒体通稿。
先说好的:这是真功夫
这份工程成色值得先肯定再开刀。CED 把 40 层 Transformer 拆成 20 层因果编码器 + 20 层解码器,prefill(读输入)时每个 token 只激活 80 亿参数,decode(生成)时激活 160 亿——552B 的大底座,读得便宜、想得贵。Compressed Sparse Attention 2 加上 FP4 的 KV 缓存,把全局 KV 压到 890 字节/token(约 V4-Flash 的四分之一、V1 的 1/437),SWA Bounded Replay 这个部署技巧又把持久化(SSD/内存)缓存压到约八分之一。上下文从 4K 拉到 1M(256 倍),单 token decode 的 FLOPs 只涨约 25%。从零开始训了 45T token。对于整天反复读同一个代码仓库的 coding agent 这种输入密集型负载,这正是该优化的方向——这份架构论文比分数表有意思得多。
标题数字没告诉你的三件事
第一,0.2 个百分点的”胜利”就是平局——厂商自己的表证明了这一点。 DeepSWE v1.1:74.2(Flash)对 74.0(Opus 5)对 73.0(Sol),全是 effort=100 跑的。DeepSeek 自己的评测说明里写过:0.3 以内的分差视为等价(原话针对 base 模型评测,但道理通用)。更致命的是 DeepSeek 自己的 scaffold 对照表:同一个 checkpoint 在 8 种 harness(Claude Code、Codex、OpenCode、Pi、mini-SWE、三种 DeepSeek Harness 模式)下,DeepSWE 得分从 65.5 到 74.2——光 harness 就能晃出 8.7 个百分点,是那 0.2 个百分点差距的四十多倍。更新一下我的老规则:agent 类基准上,harness 不固定且不公开的,9 个百分点以内的差距一律按平局处理。
第二,所有标题数字都是 reasoning effort=100 跑出来的——这是最不经济的档位。 技术报告自己的曲线:effort 从 25 拉到 100,DeepSWE 从 66.0% 涨到 74.2%,Terminal-Bench 2.1 从 82.4% 涨到 90.6%,代价是约 2.5 倍的输出 token。而 60–80 这个区间已经能拿回接近满档的大部分精度,token 花费不到一半;最后冲到 100 那一步,agent 轨迹拉长 1.6–1.8 倍,涨分却微乎其微。DeepSeek 公开 API 的三档预设是 low=50、high=75、max=100。榜单配置不是生产配置——把榜单配置原样搬进生产,等于多花 2.5 倍 token 买个位数的涨分。
第三,这张表并不全是赢——要看完整的一行。 Terminal-Bench 3.0:30.0 对 Opus 5 的 43.3;4.0:31.2 对 51.8;ExploitGym:15.3 对 GPT-5.6 Sol 的 33.7;GPQA Diamond:90.9 对 Sol 的 94.1。SWE 形态的任务它赢,terminal 运维形态的任务它输得很惨。这不是缺点,这是重点:按你的 workload 形态买模型,别看标题格。(顺带给 DeepSeek 记一功:输的格子也原样公开了,值得更多厂商学习。)
真正的故事:计费单位变成了缓存
非高峰时段,DeepSeek 的缓存输入价格是每百万 token 0.003 美元(cache miss 0.15 美元,输出 0.60 美元;高峰时段——周一到周五 01:00–04:00 和 06:00–10:00 UTC——正好翻倍)。算一笔 builder 的账:一个 agent 维护 50 万 token 的可复用前缀(仓库、工具定义、系统提示),100 次请求都命中缓存,就是 5000 万缓存输入 token。V4.1-Flash 非高峰只要 0.15 美元,Kimi K3(缓存 0.30 美元/M)要 15 美元,GPT-5.6 Sol(0.40 美元/M)要 20 美元,Claude Opus 5(0.50 美元/M)要 25 美元。在长期运行的 agent 工作负载里占比最大的这部分 token,价格差是 100–166 倍——而几个基准上的分数差距还在噪声范围内。
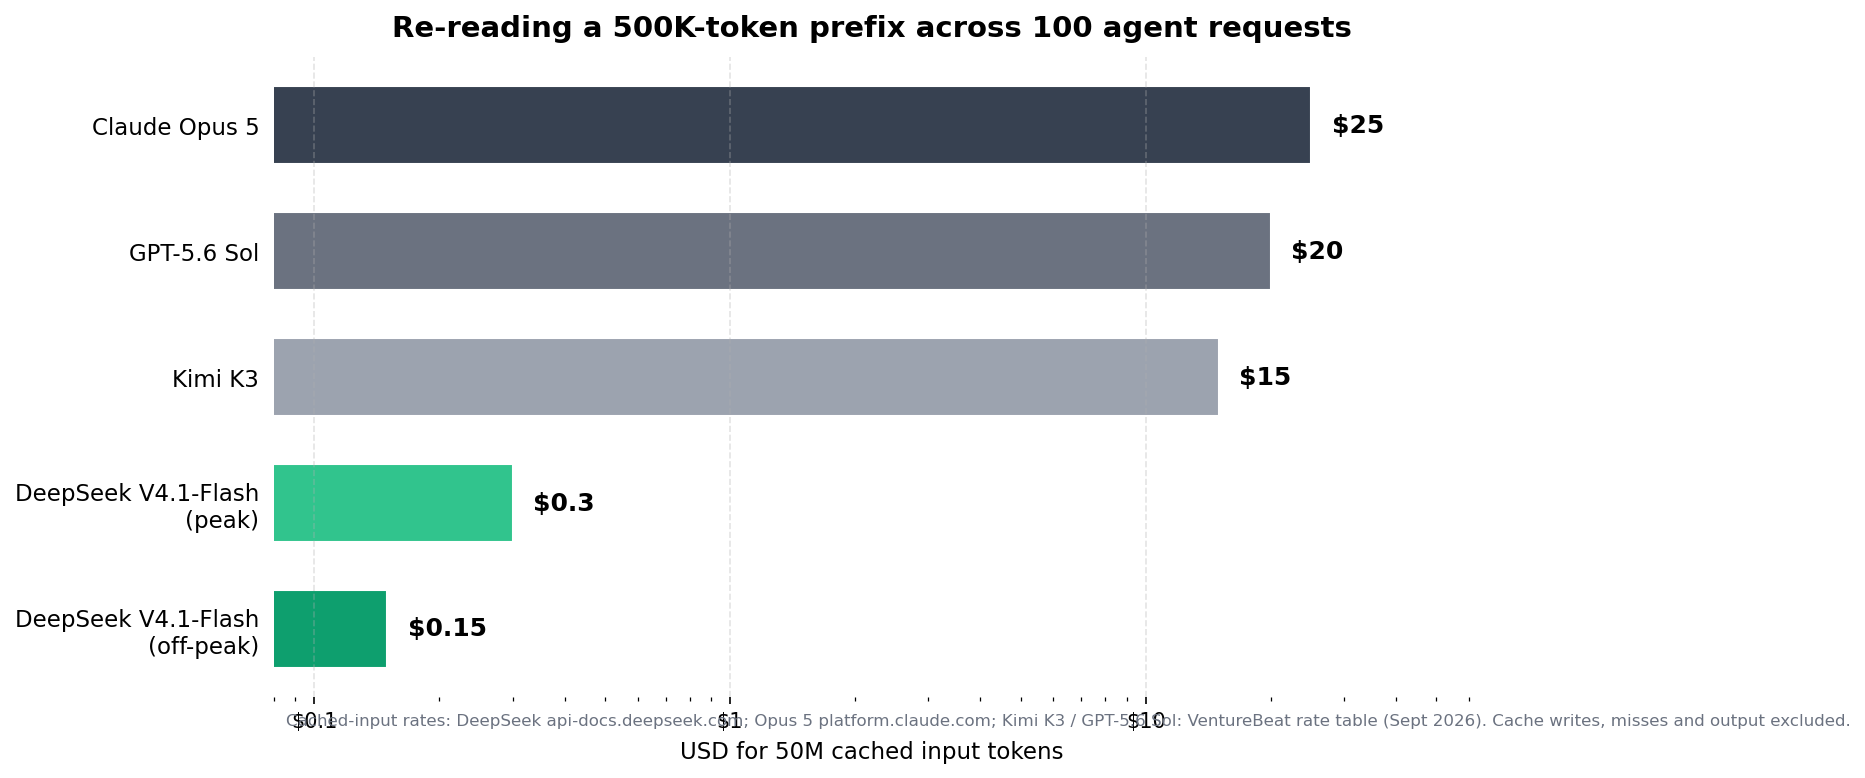
监控还没跟上经济学。VentureBeat 2026 年 7 月对 170 家企业的调查:只有 47% 严格追踪 AI 算力成本和 ROI,只有 31% 把”每百万 token 成本”当作核心基建指标。如果你是那 53% 里不追踪的,你就是在闭眼谈判:只看未缓存输入单价比模型,会漏掉 agent 账单里增长最快的那一块。
周一早晨 checklist
- 这周把每个 agent 任务的缓存命中率记下来——缓存输入 vs 未缓存输入 token 数,以及每个完成任务的成本。如果缓存读占输入 token 的 80% 以上,选哪个模型就是二阶决策。把能调度的批量 agent 任务挪出 DeepSeek 的高峰窗口(周一到周五 01:00–04:00、06:00–10:00 UTC,其余都是非高峰)。
- 按任务难度分档设 reasoning effort:lint 和常规改动用 low(50),功能开发用 high(75),只有真正难啃的调试才上 max(100)。永远别把榜单配置复制进生产。
- 厂商 agent 基准差距在 ~9 个百分点以内的,一律按平局处理——除非 harness 固定且公开。迁移之前,先在自己的 trace 上重跑一遍。DeepSeek 这次亲手递上了证据。
- 锁死模型标识,厂商侧路由变更后重跑 golden eval。 DeepSeek 本来宣布 9 月 14 日起把 V4-Pro 的 API 流量全部切到 Flash——遭到开发者反对后又撤回,V4 Pro 继续服务、计费不变。静默换模型是真实存在的依赖风险,而这周证明了社区 pushback 是管用的。
辩论
如果一个缓存 token 便宜 100 倍的模型,在你的 agent 基准上和 frontier 模型打得有来有回,那你付 frontier 的溢价到底在买什么?我的判断:frontier 正在变成”最难的 5% 任务的延迟+输出质量产品”,剩下的全是缓存管理问题。frontier 溢价在输入密集型负载上还有哪里赚得回票价——terminal 运维、安全,还是我漏掉的什么?
来源
- 模型卡与评测表:huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
- 技术报告 PDF(§5.3.2–5.3.4):huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/resolve/main/DeepSeek_V41_Tech_Report.pdf
- 官方定价(Flash 缓存输入非高峰 0.003 美元/M,高峰 2 倍):api-docs.deepseek.com/quick_start/pricing
- Claude Opus 5 缓存定价(0.50 美元/M 缓存命中):platform.claude.com/docs/en/about-claude/pricing
- Kimi K3 / GPT-5.6 Sol 缓存价格(0.30 / 0.40 美元/M):VentureBeat 费率表,2026 年 9 月
- V4-Pro 路由宣布与撤回:TechNode,9 月 10 日 + DeepSeek API 文档注 2
- 企业 AI 成本追踪调查:VentureBeat Pulse Research,2026 年 7 月(n=170)
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀