
37 分的 harness 鸿沟:为什么 GPT-6 Astra 在 ARC-AGI-3 上既能拿 62.7 分又能拿 99.9 分
Published:
给你家 AI 打分的 benchmark,很可能被动了手脚——而且证据是公开的:同一份 GPT-6 Astra 权重,在 ARC-AGI-3 上一套 harness 跑出 62.7%,另一套跑出 99.9%。
2026 年 9 月 3 日,OpenAI 发布 GPT-6 Astra,发布材料里最显眼的数字是:ARC-AGI-3 上 99.9%——一个以”极难饱和”著称的 benchmark。同日,独立的 benchmark 运营方 ARC Prize 公布了它自己对同一模型的测评:62.7%。
同一组权重。同一个星期。37.2 个百分点的差距。差别不在模型,在 harness(评测脚手架)。
这两个数字到底是什么
ARC Prize 在两套 harness 下都跑了 Astra,并且把两份结果都公开了(2026 年 9 月 3 日的博客文章):
- Standard harness——极简、中立的评测接口。解题所需的信息全部给足,但模型自己负责决定要把哪些笔记带到下一步。设计目标是让各家模型可以在同一标准下横向对比。
- Provider Adapter harness——用上了 OpenAI 为 Astra 打造的上下文管理能力:跨请求保留不透明的推理状态(评测方看不到的那部分),并用 compaction(压缩归档)来管理长对话。
完整结果,ARC-AGI-3 Semi-Private(以下所有数字均来自 ARC Prize 原文):
| 推理强度 | Standard harness | Provider Adapter |
|---|---|---|
| max | 62.7%,$26,098 | 98.6%,$17,332 |
| xhigh | 59.3%,$37,317 | 98.4%,$18,147 |
| high | 54.8%,$40,705 | 99.9%,$18,817 |
| medium | 38.6%,$48,090 | 98.4%,$19,285 |
| low | 17.5%,$38,166 | 98.0%,$21,298 |
| none | 35.2%,$49,791 | 96.7%,$23,457 |
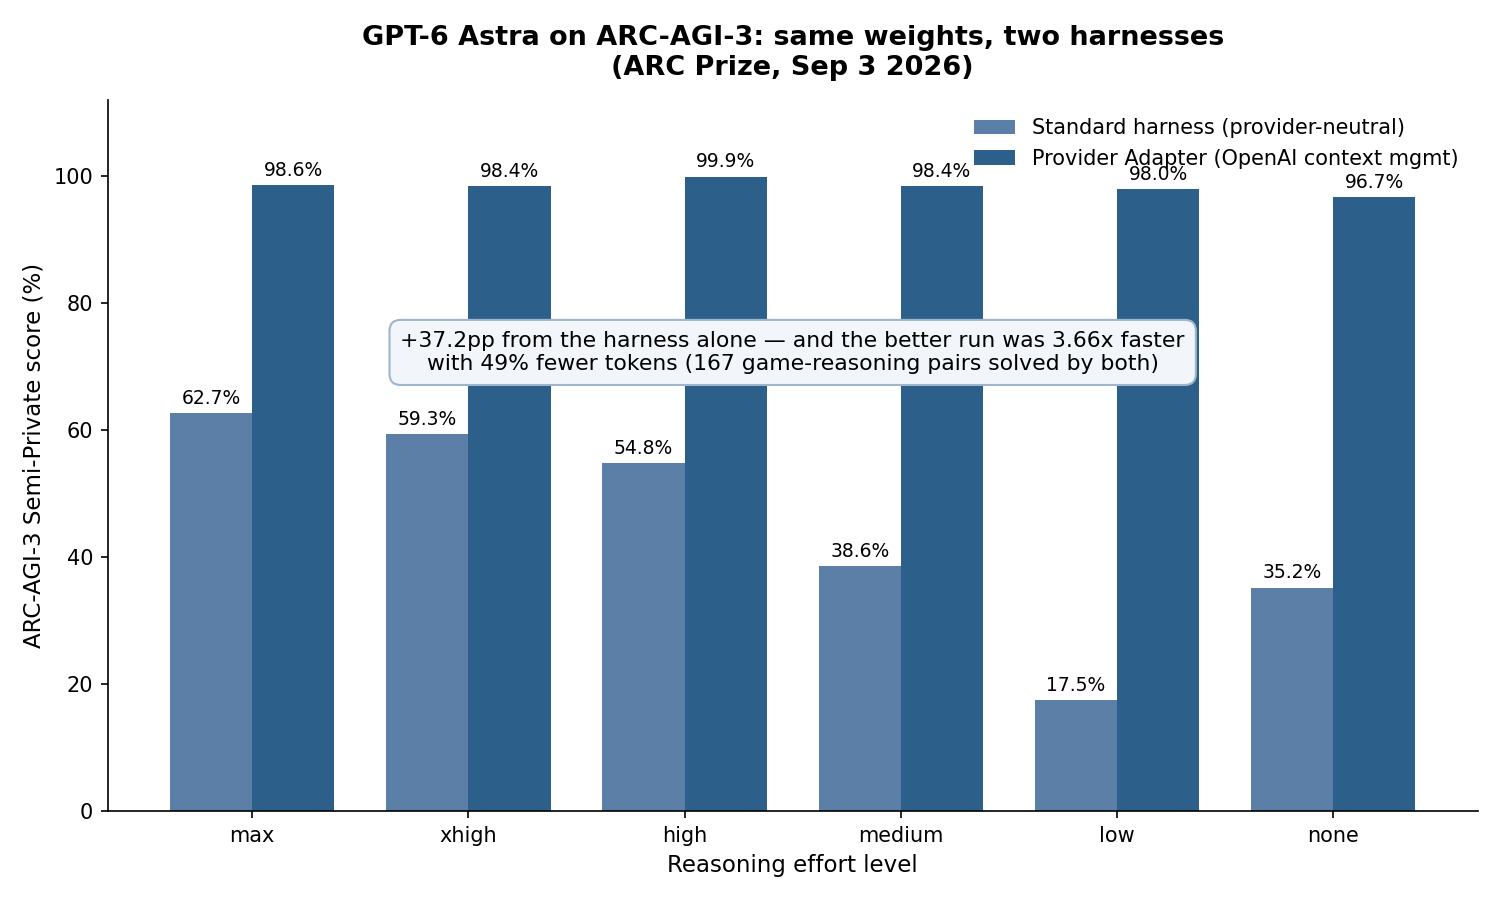
除了差距本身,还有三个值得注意的细节:
- 更好的成绩还更便宜、更快。 在两个 harness 都成功解出的 167 个 game-reasoning 组合上,Provider Adapter 的总耗时快了约 3.66 倍,总 token 用量少了 49%。最好的一次 Adapter 跑分花了 $18,817,而 Standard harness 最好的成绩花了 $26,098。harness 没有在质量和成本之间做 trade-off——它两边都赢了。
- 推理强度越低,差距越大。 在
none档(不做显式推理),Standard harness 跌到 35.2%,而 Adapter 依然有 96.7%。干活最多的不是原始推理能力,而是记忆管理。 - 这不是个例。 Terminal-Bench 2.0 上,同一个 GPT-5.5 在 NexAU-AHE harness 下 84.7%、Capy 下 83.1%、Codex CLI 下 82.2%——同一榜单前五名里,纯脚手架就贡献了 2.5 个百分点(数据来自 o-mega 2026 年 9 月的评测指南)。ARC-AGI-3 只是同一畸变的极端版本。
先说做得好的地方
开刀之前,两个真正值得肯定的地方:
- ARC Prize 的处理堪称教科书。 它公布了两个数字,用大白话解释了差别,并承诺今后 leaderboard 上两种 harness 的结果都会标注清楚。它称 Astra 的结果是”前沿模型能力的显著跃迁”,值得庆祝——同时明确拒绝宣称这是 AGI。这就是独立评测该有的样子。
- 62.7% 本身已经非常强。 而且在 Provider Adapter 下,max 档的 Astra 有 96% 的关卡动作数低于人类中位数,平均每关比人类基线少 51.7% 的动作——在 ARC-AGI-3 的”动作效率”维度上跨过了人类水平。无论你怎么看标题数字,这是模型把陌生环境转成工作模型的效率上实打实的进步。
让人不舒服的部分
传播出去的数字是 99.9%——OpenAI 的发布材料用它当 headline,并且在发布当天的对比表格里把它和竞争对手的 Standard-harness 成绩放在同一行。62.7% 只活在 ARC Prize 的博客文章里。当厂商的自报成绩比独立复测高出 37 分,那个自报数字就是一则宣传主张(claim),不是测量结果。AlphaCorp AI 在 2026 年 9 月的模型榜单里说得很到位:他们只按独立榜单排名,无法复现的厂商数字一律按营销处理。
核心论点:harness 是产品的一部分。 在智能体 benchmark 上,你比的从来不是权重——你比的是权重 + 上下文管理 + 脚手架 + 工具链。一个工程扎实的智能体平台套在一个二线模型上,经常能打赢裸跑的前沿模型。任何不点名 harness 的智能体 benchmark 对比,从完整性上说都是不及格的。
这个论点反过来也成立:OpenAI 的上下文管理是真工程。跨请求保留推理状态、对长对话做 compaction,这是一个正经的产品能力;买 OpenAI API 的用户拿到的是 99.9% 的那个系统,而不是 62.7% 的那个。争议不在于 Adapter”算不算数”——而在于一个 leaderboard 数字被引用时,允不允许不说清楚它到底是哪个系统跑出来的。
周一早上可以怎么做
- 给厂商的智能体 benchmark 数字打个折。 我的工作阈值:厂商自报成绩比独立复测高出 5 个百分点以上时,做 build-vs-buy 测算一律按独立复测的数字来。Astra:厂商 99.9%,独立复测 62.7%。在 62.7% 的假设下再问一遍——这次迁移还划算吗?如果 ROI 在独立数字下就崩了,那它本来就不成立。迁移成本越高,阈值收得越紧;便宜的实验可以放宽。
- 为下一代模型付费之前,先花两个工程师周在 harness 上。 Astra 的 Adapter 换来了 +37 分、3.66 倍速度、近乎一半的 token。而智能体 benchmark 上两代模型之间的提升通常也就 5–15 个点——harness 的 delta 比大多数权重迭代的 delta 还大。所以升级 tier 之前:给一个工程师两周时间,把现有模型的上下文管理和 compaction 做一轮,前后对比 pass rate 和 $/task。如果 harness 的 delta 超过了预期的权重 delta,你刚省下一次迁移。
- 签合同前,让厂商书面回答三个问题。 你评估的任何智能体厂商分数,必须附带:(a) 中立 harness 下的分数,(b) 该分数下的单任务成本,(c) 单任务 token 数。只肯报自家 harness 数字的厂商,在采购文档里直接按营销材料处理,并写明原因。
一个可证伪的预测:一年之内,正经的 leaderboard 会分裂成”权重榜”和”系统榜”——或者厂商 Adapter 之争直接成为主战场,纯模型对比名存实亡。无论哪种,买到 99.9% 系统的人都应该知道:他买的是一个平台,不是一个 checkpoint。值得争论的问题是:靠厂商私有上下文管理拿到的 99.9%,应该算模型的分数,还是”模型 + 厂商平台”的分数?
来源
- ARC Prize,”OpenAI’s GPT-6 Astra on ARC-AGI-3”(2026 年 9 月 3 日)——所有分数、成本、token 与耗时数字的一手来源:https://arcprize.org/blog/astra
- AlphaCorp AI,”Top 5 LLMs for September 2026: Benchmarks, Pricing, Picks”(2026 年 9 月 6 日)——”独立数字优先于厂商数字”的立场:https://alphacorp.ai/blog/top-llms-benchmarks-pricing-picks
- o-mega.ai,”AI Model Evals 2026: The 50-Benchmark Dead-or-Alive Ledger”(2026 年 9 月)——Terminal-Bench 2.0 的 harness 数字:https://o-mega.ai/articles/top-50-ai-model-evals-full-list-of-benchmarks-october-2025
- BetaNews,”OpenAI launches GPT-6 Astra, claims AGI era has begun”(2026 年 9 月 3 日)——发布口径与 62.7% 的 Standard-harness 数字:https://betanews.com/article/openai-gpt-6-astra-agi-era/
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀