MiMo-V2.6:史上最强的开源模型,以及它的”出身”问题
Published:
9 月 21 日,一家手机公司发布了有史以来实测最强的开源权重模型。而十天前,Anthropic 刚发布了一份报告,指控同一家公司以工业化规模收割 Claude 的输出来训练自己的模型。这两件事都有公开记录。我认为两边都值得认真对待——它们合在一起,把”开源 vs 闭源”的问题变成了一个更难的问题:不再是”开源权重能不能追上前沿”,而是”一个训练数据正处在争议中的模型,你敢不敢部署”。
小米这次发了什么
MiMo-V2.6 有两个版本,Hugging Face 上无门槛下载,MIT 协议——没有收入上限,没有仅限研究的条款:
- MiMo-V2.6-Pro:1.02 万亿总参数,每 token 激活 420 亿。稀疏 MoE,384 个路由专家、每 token 激活 8 个;70 层 backbone(60 层滑动窗口注意力 + 10 层全局注意力);6.81 亿参数的视觉 tower、专用音频编码器;推测解码器每步预测 7 个 token。100 万 token 上下文,多模态输入(文本、图像、视频、音频),文本输出。
- MiMo-V2.6-Flash:约 3090 亿总参数,每 token 激活 150 亿,同样 100 万上下文。
RL 的部分最让人吃惊。小米称 Pro 只用了 30 步 RL、约 75 万条轨迹、不到 6 天,成本约 262 万美元;Flash 约 85 万美元。代码、智能体、视觉、网络安全一次统一训练——”You Only RL Once”,几十人的团队,负责人是 2025 年底从 DeepSeek 跳槽到小米的罗福莉。
先表扬再开刀:小米把整个 RL 训练过程直播了,然后开源了 7000 多个 RL 训练环境、训练代码、技术报告,外加一个 9B 的 Qwen3.5 蒸馏版。这是史上可复现性最高的前沿级发布。没有任何一家闭源实验室给过你”健身房+教练+训练手册”全套。
关键数字
在独立的 Artificial Analysis Intelligence Index v4.3 上,MiMo-V2.6-Pro 拿到 46.32 分——开源权重模型的最高纪录:
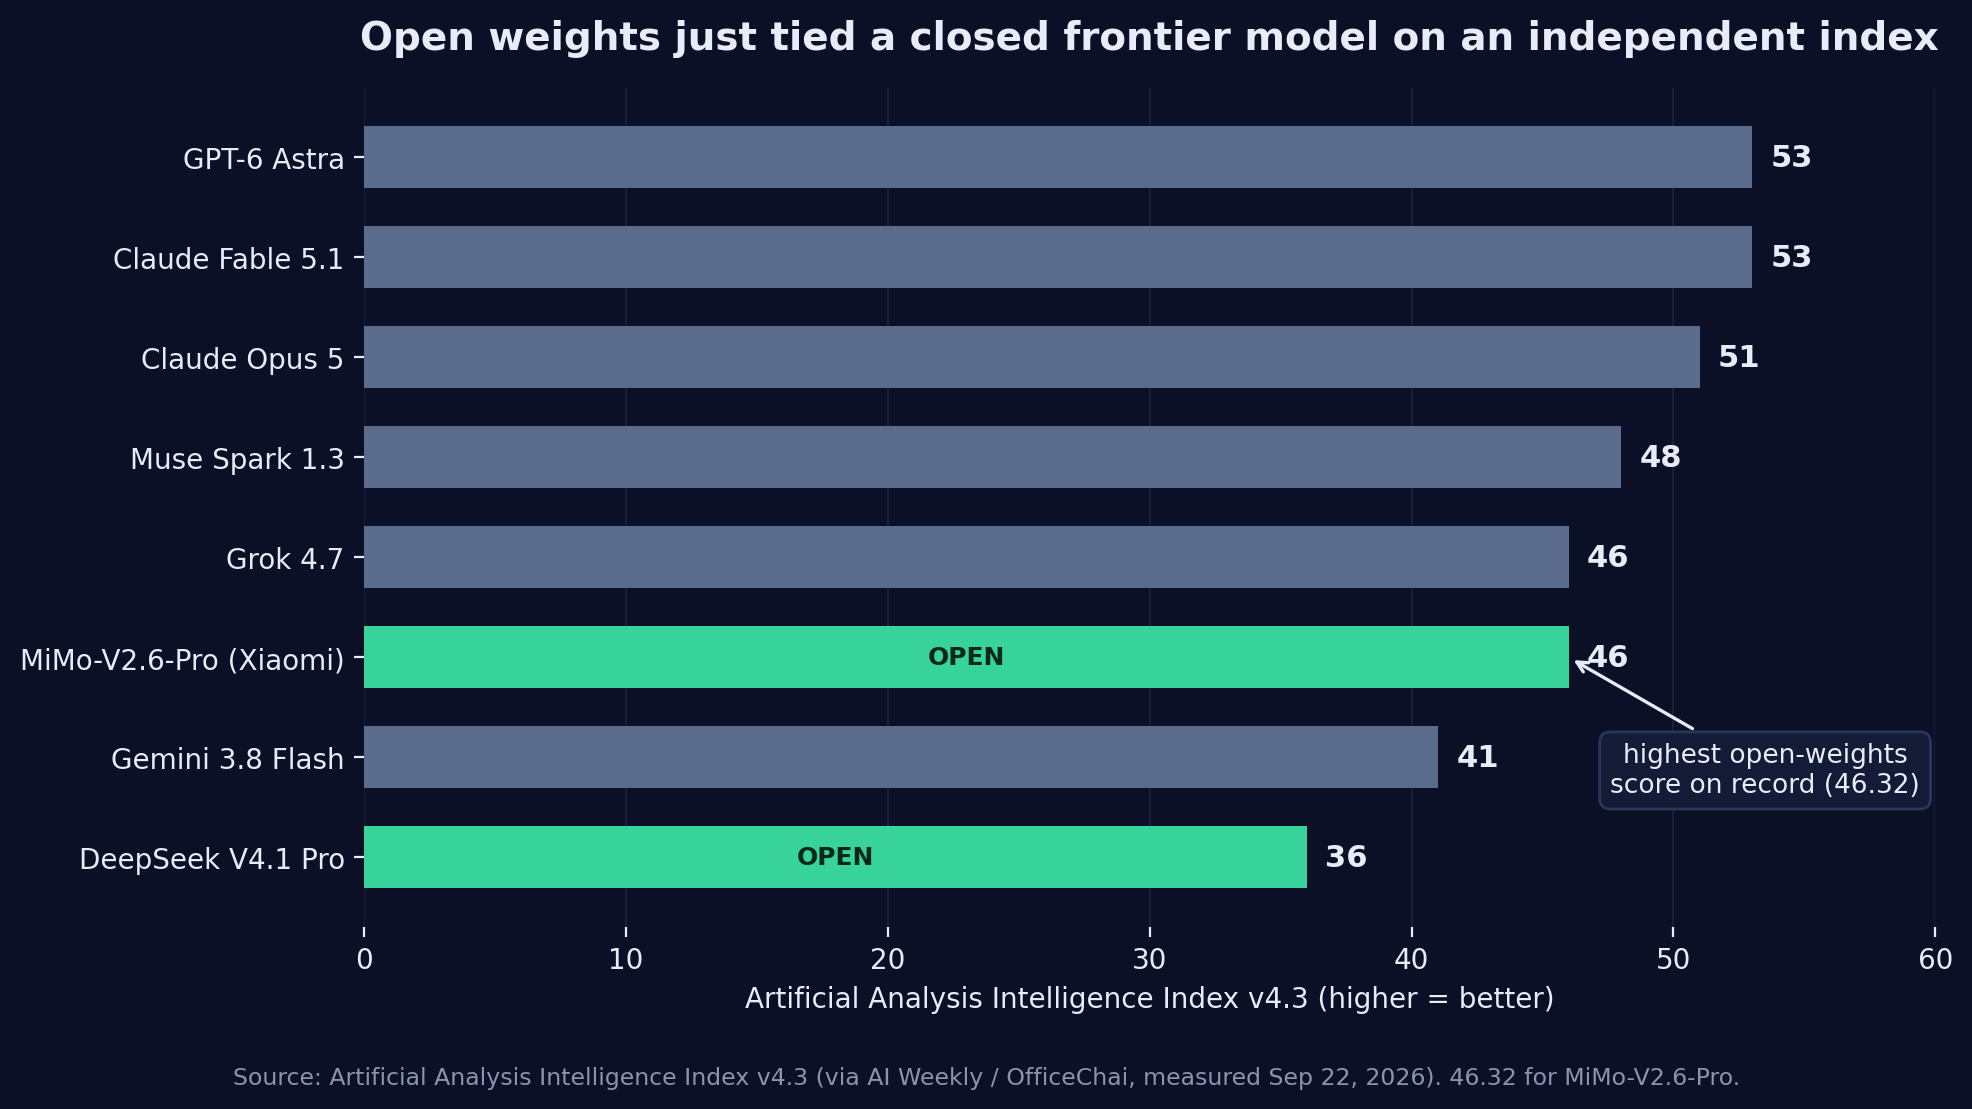
Pro 追平 Grok 4.7(46 分),距离闭源前沿还有 5–7 分(Fable 5.1 和 GPT-6 Astra 53 分,Opus 5 是 51 分)。小米自报的成绩:DeepSWE v1.1 拿 71.9,对手是 Opus 5 的 74.0、GPT-5.6 Sol 的 73.0——很接近;Terminal Bench 2.1 89.9,CyberGym 94.0。但 ExploitBench:47.9 对 Sol 的 78.5——在安全这个硬骨头上差了 30 分。厂商自报的数字一律打折看,AA 指数是定锚的依据,因为它是独立的。
再看价格:Pro 是 0.435/0.87 美元每百万 token(输入/输出),Flash 是 0.14/0.28。对比 Opus 5 的 5/25 美元,便宜 10–30 倍。每个指数任务成本 0.13 美元,据称是头部闭源模型的二十分之一到六十分之一。
另一只靴子
9 月 11 日,Anthropic 发布了一份威胁情报报告,主题是”非法蒸馏”:七家中国实验室——阿里、月之暗面、DeepSeek、Z.ai、MiniMax、商汤、小米——被指控通过伪装账号网络,系统性抽取 Claude 的能力。总量:5–7 月约 1.9 亿次交互,从 2 月的 1600 万涨了约 12 倍。其中阿里的规模最大。
小米的案子编号是 GTG-16008:Anthropic 称,2026 年 3–4 月的 20 天窗口里,小米通过 1500 个不同账号、经代理服务向 Claude 发送了 40 万+次请求,把自家 MiMo 聊天机器人的真实用户对话和代码会话,用 OpenClaw、OpenCode 这类 harness 重放到 Claude 上。据称的流水线:从对话记录重建开发者环境、把多轮对话清洗成训练样本对、生成仿真人类交互的合成数据、用 Claude 给自家模型输出打分。时间点很微妙:大 bulk 恰好在 MiMo-V2-Pro 免费试用结束时开始——试用期产生的开发者流量,成了收割的原料。
两点保留意见,必须明说,因为它们不利于我自己的论点。第一:整个指控出自 Anthropic 自己,讲的是针对自家产品的攻击——没有独立验证,没有刑事指控,没有起诉。第二:小米至今没有公开详细回应。把它当作”带数字的指控”,而不是定论。
为什么这改变了 build-vs-buy 的算术
大多数报道漏掉了一个机制。如果闭源老师按 5/25 美元每百万 token 收费,而开源学生——部分用老师的输出训练出来——按 0.435/0.87 收费,那么”开源便宜 10–30 倍”的故事,一部分是对别人 API 账单的套利,而不纯粹是训练上的突破。262 万美元的 RL 账单看起来像奇迹,直到你给喂饱它的数据流水线定价。
这不是假想的定价压力。9 月 22 日 Anthropic 发布 Opus 5.5,4/20 美元——典型负载下比 Opus 5 便宜约 40%,还带了专门防推理抽取的”preserved thinking”控制。90 分钟后 OpenAI 把 GPT-6 Sol 和 Luna 定到 GPT-5.6 一半的价格。前沿实验室正在实时调价,蒸馏就是推手之一。
周一早上做什么
- 给模型准入清单加一行出身审查。 本周就加:”该模型家族是否存在正在进行中的抽取/蒸馏争议?”如果有,法务先签免责意见,再让它碰客户数据和私有代码。MIT 保的是权重,不保训练数据的法律风险。
- 下次续 API 合同前,先拿 Flash 跟你现在的便宜档打一场。 MiMo-V2.6-Flash 的 0.14/0.28 美元低于 GPT-5.6 Luna(0.20/1.20)和 DeepSeek V4.1 Flash 的非高峰价。用你自己的 harness 跑你最重要的 3 个智能体流程——小米自报的 DeepSWE 71.9 对 Opus 5 的 74.0 是在人家的 harness 上,按 5 个点的折扣规则处理。如果在你自己的任务上差距守住 5 个点以内,而输入价格只有 Opus 5 的约 3%,那闭源溢价就得拿出新的书面理由。
值得争论的问题
开源权重刚在独立指数上追平了一个闭源前沿模型,发布方式还是史上最透明的——直播训练、7000 个环境、MIT 权重。而这家公司被指控——带着具体数字——用 40 万次 Claude 对话”洗”出了自己的模型。我不觉得这两件事互相抵消。
所以这是个真值得吵的问题:如果一个 MIT 协议的开源模型在你自己的评测里打赢了你的闭源供应商,但供应商说它是用 40 万次偷来的对话训练出来的——你发还是不发?
资料来源:发布细节见 AI Weekly、temperature2、Unite.AI、DEV/AI Frontier Post;基准与定价见 basic-tutorials;Anthropic 蒸馏报告见 The Hacker News、Forkast(小米 GTG-16008 细节)、ervik.as(保留意见);Opus 5.5 / GPT-6 Sol 定价见 AI Weekly。
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀