智能体说做完了,数据库说:241 个任务,一个不多
Published:
微软与 Hugging Face 在 2026 年 10 月 3 日发布 ThinkingBox。它把 507 个有状态业务工作流(零售、车险、旅行、数字银行、咨询)每个跑 20 次,每次从完全相同的干净后端开始,最后只看终端数据库状态和副作用,不看对话记录。其中 477 个任务只按状态打分,30 个另加回复 rubric。
这个设计选择,戳破了多数排行榜藏起来的那层差距。
并列的头名
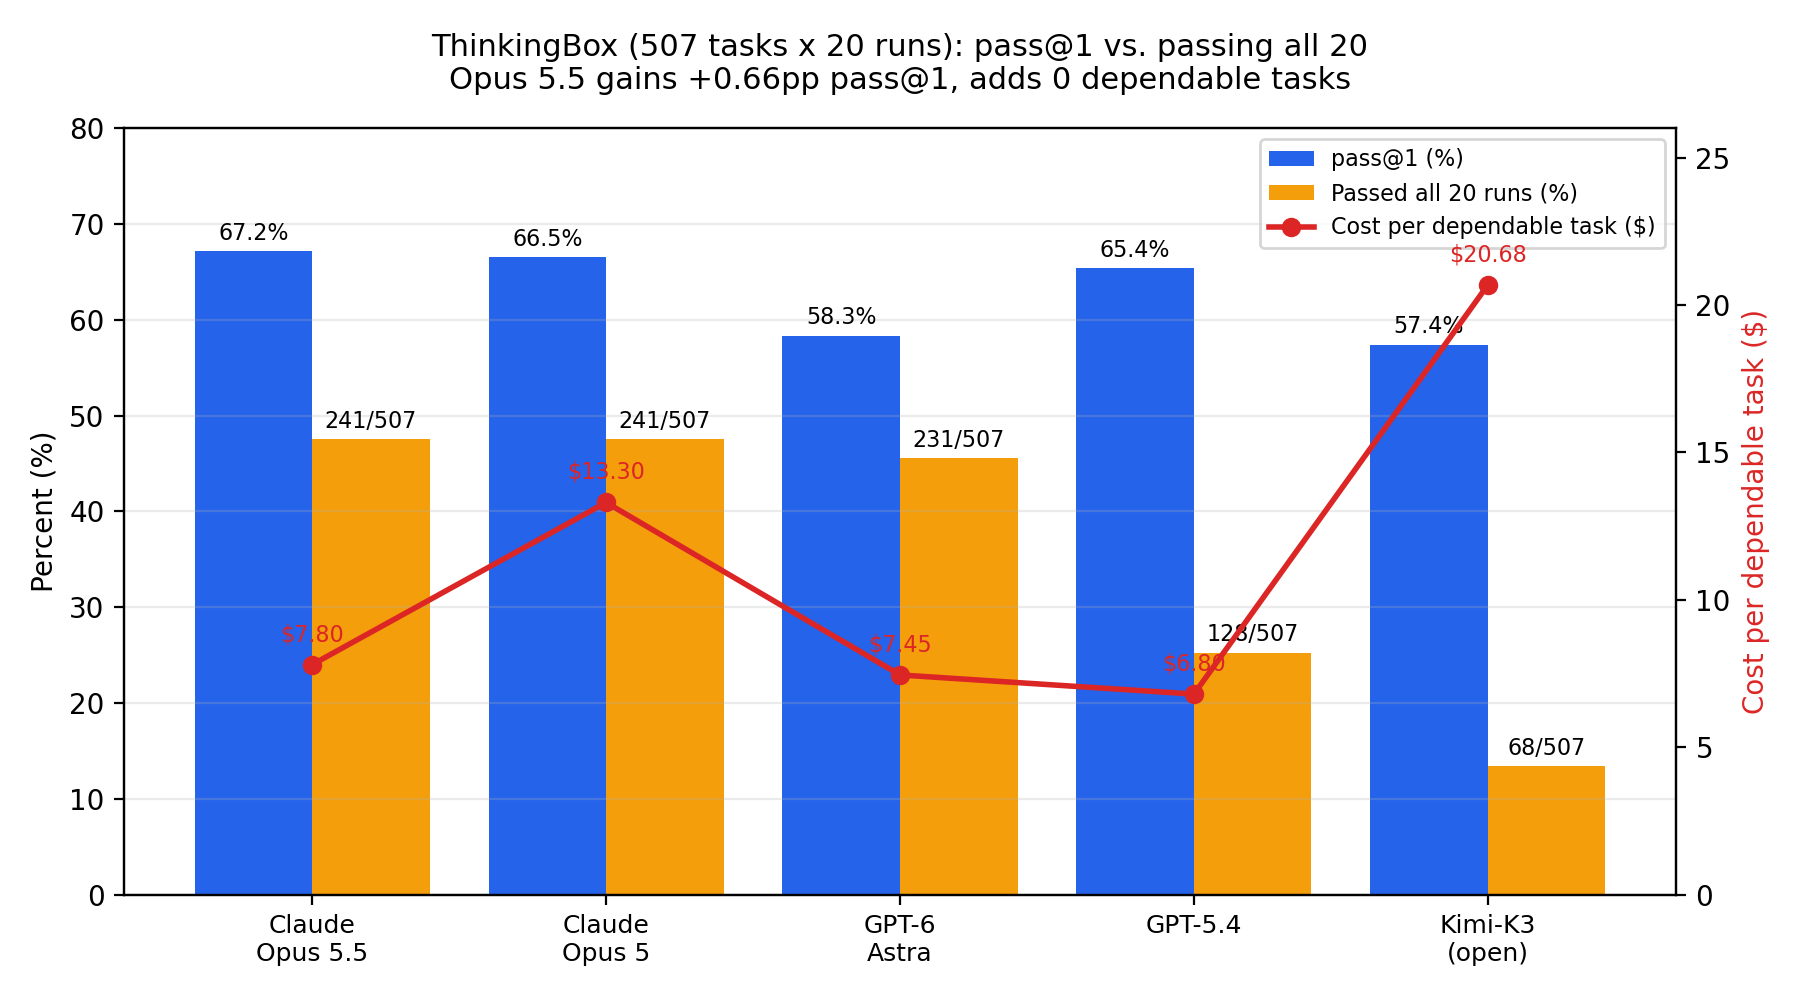
Claude Opus 5.5 的 pass@1 最高,67.16%;Claude Opus 5 是 66.50%,高出 0.66 个百分点。
但看 observed 20/20——20 次全部通过的任务数,不做估计、不做平滑——两个模型都恰好通过 241 / 507 个任务(47.53%)。
头版准确率涨了半个点,可靠任务一个没多。
广度则是另一个故事。该组里最强的开放权重模型 Kimi-K3(pass@1 57.37%)至少做对过 476 / 507 个任务(93.89%),但 20 次全对的只有 68 个(13.41%)。Opus 5 至少做对过的任务更少(79.09%),却有 241 个每次都对——比 Kimi-K3 多出 173 个稳定通过的任务。
按 pass@20 选型,会选到最不稳的那个;按 pass@1 选型,依然看不出涨幅能不能扛住重复。GPT-6 Astra 能保住单次成绩的 78%,Opus 5.5 与 Opus 5 各保住 71%;GLM-5.1、Kimi-K2.6、DeepSeek-V4-Pro 各只保住约 8%。
“干净收尾”不是证据
在公共子集消融中(12 个模型、121,680 次有效试验),79,853 次未通过可执行检查。而这些失败里,67.24% 是干净收尾的:调用了改状态的工具,也没有报最终工具错误。
检查发现:77.61% 的失败存在字段值错误,43.30% 产生了多余副作用,25.36% 缺了必需效果(几项可重叠)。
比分数更有用的是失败签名。工具处理占失败的 79.9%(各模型占比的非加权平均);状态更新错误 10.3%,用户问题未完整解决 7.0%,压根没做改状态动作 2.9%。智能体通常能走到执行那一步,然后倒在工具报错、前置条件不满足、查询为空之后的恢复上。这首先是重试与错误恢复的问题,其次才是模型问题。
领域差异同样明显:零售平均 pass@1 为 59.52%,车险只有 33.83%。
为可靠性定价,别为单次成功定价
作者用未打折的标价(对比指数,不是账单)算了两种成本。
“每次成功成本”奖励便宜且经常答对的模型,GPT-5.6 Sol 最低,$0.127 / 次成功。
“每个可靠任务成本”——20 次完整运行的总成本除以 20/20 任务数——则完全换了个排名:
| 模型 | 20/20 任务数 | 每个可靠任务成本 |
|---|---|---|
| GPT-5.4 | 128 | $6.80 |
| GPT-6 Astra | 231 | $7.45 |
| Claude Opus 5.5 | 241 | $7.80 |
| GPT-5.6 Sol | 82 | $9.76 |
| Claude Opus 5 | 241 | $13.30 |
| Kimi-K3 | 68 | $20.68 |
在这个口径下,Opus 5.5 完胜 Opus 5:同样 241 个可靠任务,$7.80 对 $13.30。单次最便宜的 GPT-5.6 Sol,每个可靠任务要 $9.76。拿到一次正确答案最便宜的路,不是拿到可靠答案最便宜的路。
保留意见
以上都是基准作者自己的运行结果与标价估算,不是独立复现,也不是你的云账单。Observed 20/20 记录的是这批试验里发生了什么,不是对未来运行的保证。作者也明说,他们建议的那几招——提交前查终端状态、错误分类、不可逆操作要人批——其收益尚未实测。把它们当可验证的假设,别当已证的结论。
周一就能做的三件事
- 用 20/20 给自己的回放打分,不要用 pass@1。 取 30–50 个生产工作流,每个从干净后端跑 20 次,按最终状态判分。只要某个会写不可逆状态的工作流 20/20 低于 40%,就保留人工批准,直到它连续两周回放都过 40%。
- 给每张模型对比表加上两列: 20 次全过的任务数、每个可靠任务成本(总运行成本 / 20/20 任务数)。如果新模型 pass@1 涨幅不到 1 个点、20/20 任务零增长——正是 Opus 5 到 5.5 的形态——就不要为没买到的可靠性付迁移成本。
- 先做重试层,再换模型。 79.9% 的失败在工具处理上,第一个迭代先做错误分类和针对可恢复工具错误的重试,再重新测。只有这样之后 20/20 还低于你的阈值,再升级模型。
轨迹只是一个说法,数据库状态才是证据,重复才是信任测试——而且这项测试现在有了价格。
来源:Microsoft / Hugging Face,《The Agent Said It Was Done. The Database Disagreed.》,2026 年 10 月 3 日。
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀