别再给 Agent 的产出投票了,改成拿证据裁决
Published:
让 agent 更可靠的常规做法,是把同一个任务多采样几次,然后相信 rollout 们一致同意的那个答案。2026 年 10 月 1 日提交到 arXiv 的一篇论文——《VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks》(arXiv:2610.00972),作者是 Caiqi Zhang(剑桥大学,工作完成于 Google Cloud AI Research 实习期间)、Rujun Han、Zifeng Wang、Zoey CuiZhu、Nigel Collier、Tomas Pfister 和 Chen-Yu Lee——把这种直觉在长程任务上到底错得有多离谱量了出来,也给出了替代方案。
核心发现:共识是弱信号,分歧才是好东西
在 APEX-Agents 上用 Claude Opus 4.8 跑出的 10 条 rollout 池子里(该基准的 rubric 支持按主张逐条打分),作者发现:
- 34% 的共识值——即 10 条 rollout 全部同意的主张——被判为错误。哪怕每个候选答案都错了,一致性照样可以成立。
- 74% 的争议主张里包含一个正确候选,但出现频率最高的那个值只有 47% 的情况是对的。也就是说,投票会系统性地把正确答案扔掉。
这和 self-consistency 背后的直觉正好相反。在短小的数学题上,采样分布的众数是个还不错的估计量。但在长程的办公类任务里——报告、表格、多文件交付物——rollout 们会共享同一种误读:看错同一个源文件、用错同一个单位、漏掉同一条要求。此时的一致性量的是相关性信念,不是正确性。反过来,分歧恰好标出了模型不确定的位置,而正确答案通常就躺在少数派里,等着被拿去和环境证据对质。
系统设计:同一个模型,两个互相拆台的核查岗
VeriHarness 把生成器自己的模型改造成核查器——没有更强的裁判,没有参考答案,测试时也看不到评分 rubric。核查器拿到一个工作区(每条 rollout 的产物、最终状态和执行轨迹,外加任务环境本身)、一组证据工具(读源文件、重算数值、跑代码),以及一个可复用的核查技能库。协议把核查拆成两个在独立上下文里运行的岗位:
- 分歧裁决者:对每个有争议的主张,把几个竞争值逐一拿到源文件、数据和任务约束面前核对。
- 共识挑战者:对每个已达成一致的主张,先必须提出它可能错的方式——引了旧版本、用错币种、中间量对但下游错了——再拿这些假设去环境里验证。
最后由一个全新上下文做裁决,把两份证据记录合并成选型结论,并可选地生成一份修订方案。有两个设计细节值得注意。第一,核查器从不靠”通读打分”来评 rollout,每个结论都绑定一次在环境中实际执行过的检查。第二,两个岗位必须待在独立上下文里:合并成一个上下文要掉 0.8 分(附录 F 消融),这和”挑战者需要反对裁决者可能锚定的结论”是吻合的。
数据
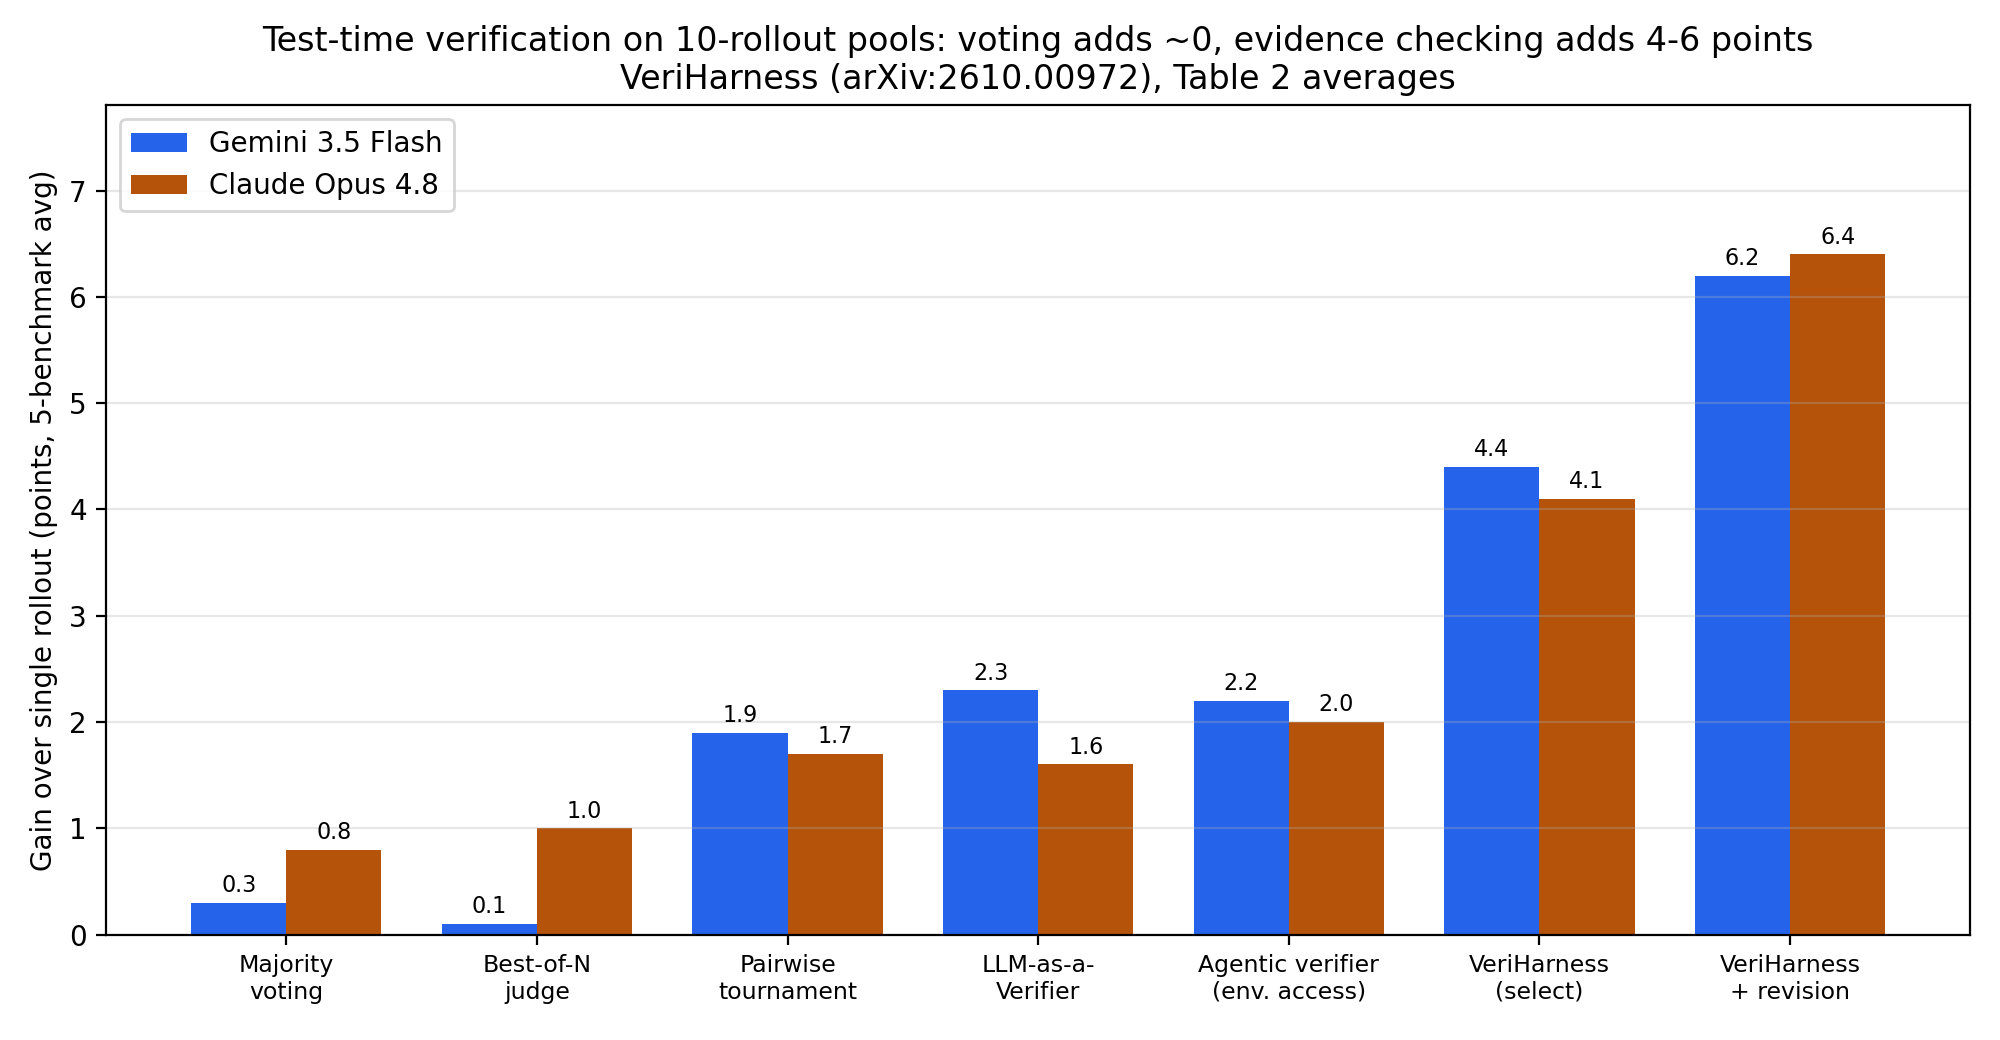
五个基准共 1,166 个任务,每个任务 10 条 rollout,每种方法跑 3 次,两个模型都既当生成器又当核查器。下表是各基准原生分数的无权重平均:
| 方法 | Gemini 3.5 Flash(均值) | 增益 | Claude Opus 4.8(均值) | 增益 |
|---|---|---|---|---|
| 单条 rollout | 47.2 | — | 49.6 | — |
| 多数投票 | 47.5 | +0.3 | 50.4 | +0.8 |
| Best-of-N + 裁判 | 47.3 | +0.1 | 50.6 | +1.0 |
| 两两锦标赛 | 49.1 | +1.9 | 51.3 | +1.7 |
| LLM-as-a-Verifier | 49.5 | +2.3 | 51.2 | +1.6 |
| 通用 agent 核查器(有环境权限、无协议) | 49.4 | +2.2 | 51.6 | +2.0 |
| VeriHarness(选型) | 51.6 | +4.4 | 53.7 | +4.1 |
| VeriHarness + 修订 | 53.4 | +6.2 | 56.1 | +6.4 |
基准明细:APEX-Agents v1.0(480 个任务)、Workspace-Bench Lite(100)、WorkBuddy Bench(200)、SpreadsheetBench 2(321)、JobBench(65)。单个格子里的最大增益出现在 APEX-Agents + Opus:35.8 → 47.5,+11.7 分。用评分器直接挑最优 rollout 的 selection oracle 在 62.7/63.1,说明核查大约收回了三分之一的可用空间,没有吃满。
还有三个结果让图景更清楚:
- 增益长在有分歧的池子里。 在 APEX-Agents + Opus 上,选型在有争议的池子里比池均值高 +6.1 分,在 154 个完全一致的池子里只高 +0.6 分。核查算力花在全员一致的任务上基本打水漂,花在吵起来的任务上才回本。
- 光有环境权限不够。 一个有同样工作区和工具、但没有协议和技能库的自由式 agent 核查器,只收回了约一半增益(+2.2/+2.0 vs. +4.4/+4.1)。起作用的是结构:裁决者 vs. 挑战者、独立上下文、最后裁决。
- 协议可移植。 把同一套指令和技能塞进 Gemini CLI、Claude Code 和 Codex 里运行,能收回大部分选型增益,代价是作者自研运行时的 2–3 倍成本。
成本
核查比生成便宜,原因是 harness 在同一个工作区里做增量调用:86–91% 的输入 token 命中缓存。按官方标价(缓存输入按 cache-read 价格计),选型成本是 Flash 每任务 $1.44、Opus 每任务 $3.92;修订约为选型的 3 倍,增益也最大。作为对照,作者报告 Flash 下选型的成本只有 LLM-as-a-Verifier 的十分之一、增益却是两倍;Opus 下约为多数投票、Best-of-N 和 LLM-as-a-Verifier 的一半——因为这些基线每次调用都要重读全部 10 条 rollout,吃不到缓存红利。如果缓存 token 按全价计,选型变成 $5.40(Flash)/$13.06(Opus),harness 依然在成本-增益前沿上。作者还释放了完整的 rollout 池:约 26,000 条,生成成本超过 $100,000,只依赖池子的方法可以直接复现,不用再跑模型。
另一个值得偷师的点是技能库能自我进化。从空库出发、只靠开发集上的失败反馈学出来的核查技能,在留出集上打赢了人工编写的技能库(相对空库基线 APEX-Agents +11.0、SpreadsheetBench 2 +5.7);从人工库出发继续进化,还能在人工库之上再加 +6.8 和 +3.7。进化出的 95 条检查里只有 5 条是在复述人工检查——48 条是把人工检查落成了具体程序(脚本、常量、文档类型),42 条是全新的,其中包括专门盯核查器自身共识盲区的检查。
把丑话说在前面
- 池子不免费。所有结果都建立在每任务 10 条 rollout 上;方法之间的比较是同等生成成本,但你的生成账单先就是单跑的 10 倍,之后才轮到核查。
- 核查器和生成器是同一个模型,这是刻意的设计。换更强的核查器分数可能更高,但那样就分不清增益来自 harness 还是模型能力差——作者明确没有跑这一臂。
- 没有校准过的 rollout 级分数;harness 是逐条主张判的。把它的记录当 reward 信号用,作者自己列为 future work。
- 挑战者的盲区是真实存在的:它放过的共享错误里,约 70% 是因为它核对的中间量本身是对的,而错误藏在更下游。它倾向于在 rollout 停下的地方停下,除非技能库告诉它还该往哪儿看。
- 核查是多轮调查,会增加墙钟延迟。作者瞄准的是质量优先于响应时间的专业交付物;对延迟敏感的聊天类产品,读法应该不同。
周一早上我会怎么做
- 在长程任务上停用多数投票做决胜。 这里它只值 +0.3/+0.8 分,基本在单条 rollout 的噪声里。如果 rollout 们在某条主张上吵起来了,那个分歧就是工单本身:送去做证据核查,而不是投票。
- 核查预算按生成开销的约 30% 预留,且优先花在有分歧的池子上。 在这套设置里,10 条 rollout 加每任务 $1.44–$3.92 的选型成本(修订再乘 3)换来 +4 到 +6 分。如果池子全员一致,核查的期望回报约等于 +0.6——直接跳过,把算力存下来。
- 让核查器真正下到环境里,且两个岗位分开跑。 靠通读打分的 Best-of-N、通用裁判最多拿到 +2.3;裁决者/挑战者拆开、每个结论都落到一次实际检查上,拿到 +4.4 起步。为了省工程量把两个角色并成一条提示词,预计要还回去约 0.8 分。
- 让核查调用在单一个工作区上增量进行。 86–91% 的缓存命中率,就是 Opus 价格下每任务 $3.92 和 $13.06 的差距。每次调用重读整个池子的 harness,会悄悄把核查账单乘以三。
这篇论文更深一层的断言,不是某个 harness 赢了基准,而是:对长程 agent 而言,一致不等于证据。过去两年大家忙着放大采样再投票。这篇工作的意思是:采样没问题——正确答案本来就在池子里,在少数派那边——有问题的是投票这一步。
出处
Zhang, C., Han, R., Wang, Z., CuiZhu, Z., Collier, N., Pfister, T., & Lee, C.-Y. (2026). VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks. arXiv:2610.00972,2026 年 10 月 1 日提交。以上数字均出自论文 Table 2、第 2、5、6 节及附录 K,于 2026 年 10 月 4 日对照 arXiv HTML 版逐项核对。
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀