Uno:让 draft model 下岗的扩散适配器
Published:
论文是 9 月 3 日发的。我现在写,是因为这个 release 这周变成了”可生产”的形状:权重开源、代码开源,第三方 coverage 也在报 serving 框架的支持。一个能真正部署的推理论文,和只能欣赏的推理论文,是两种东西。
论文 arXiv:2609.04010 · 代码和权重 · 作者来自 Institute of Foundation Models(就是发 K2 Horizon 的那个实验室)
背景:串行税为什么还没交完
自回归解码一次生成一个 token,这是硬性的串行瓶颈。业界两个主流答案各有妥协:
- Speculative decoding(EAGLE-3 一类)无损,但需要一个单独的 draft model:训练它、对齐它、做版本管理、和 target 模型保持同步,推理时还要维护两份 KV cache。数学很干净,运维很脏。
- 扩散语言模型天生并行生成,但相对好的 AR 模型有质量损失——更关键的是,大 batch 下加速比会消失(Uno 论文引用了 Wu et al. 2025、Fu et al. 2026 和 DiffusionGemma 团队的结论)。作者原话:“Batch-size-one latency captures a narrow operating regime and may overstate speedups that diminish under concurrency.” Agent 时代的负载 batch 都很重,一个在 batch 64 下死亡的加速比只是 demo,不是基础设施。
Uno 的赌注:AR 的分布原样保留,但学会从这个分布里并行采样多个 token。
Uno 到底做了什么
把参数解耦成两套:用标准 next-token 目标训练的 AR 权重(冻结),加上一套轻量扩散权重,负责并行生成 token block。扩散权重通过 “Diffusion Distillation” 学得,作者称其对训练 pipeline 的开销可以忽略。采样器家族 Ψ-Spec 做并行预测,再用 AR-verified 的拒绝采样保证无损——和 speculative decoding 无损的原理是同一套。
开源权重实验的具体配方(UnoQwen,论文 §5.2):
- 基座:开源 Qwen3-8B,AR 权重冻结
- 每个权重矩阵加 rank-128 LoRA(α=256)→ 0.35B 可训练参数(约基座的 4.4%)
- OpenThoughts3-1.2M 上训 3 epoch / 14.7B token,block-size 从 2 curriculum 到 16,32 张 H200 约 32 小时
没有单独的 draft model。一套架构,一份共享的 KV cache。
数字(论文 Table 2,Qwen3-8B)
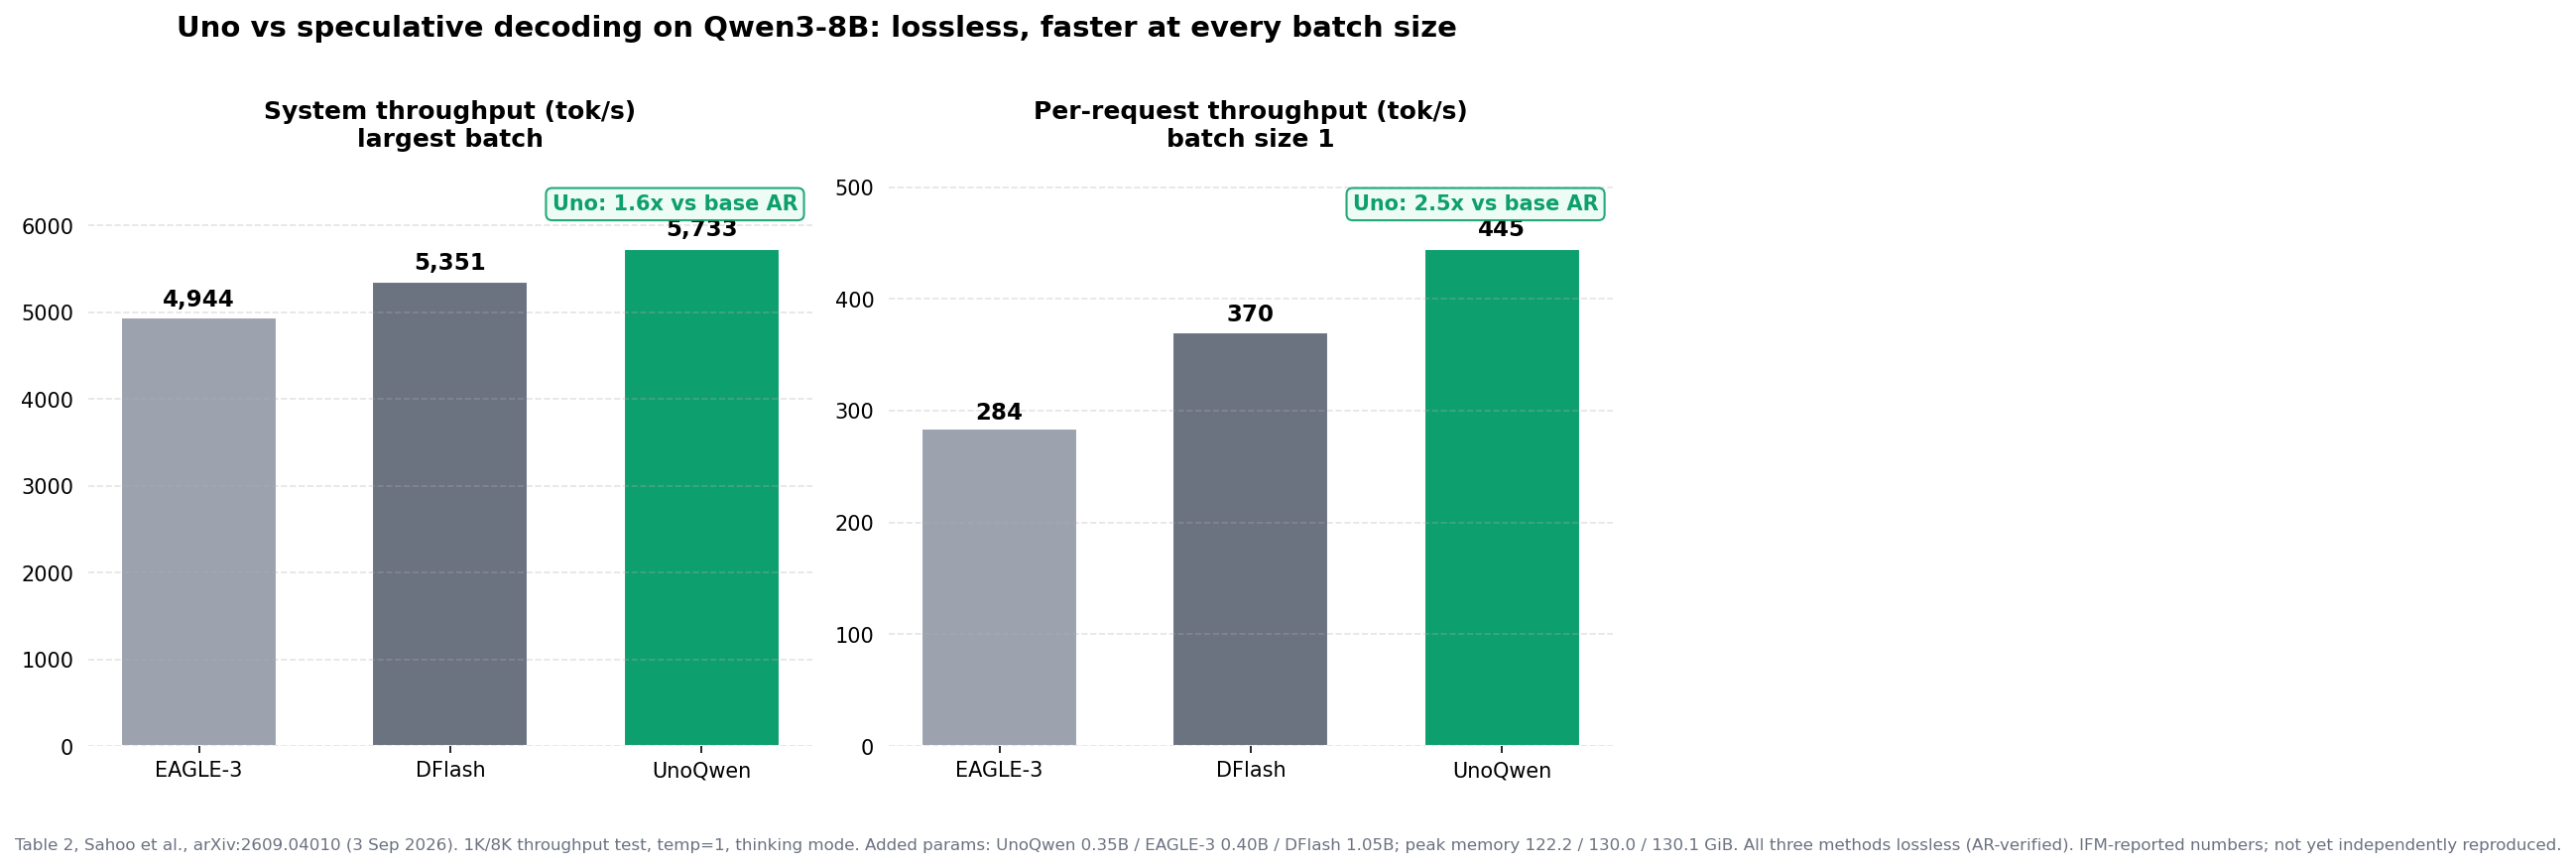
| UnoQwen | EAGLE-3 | DFlash | |
|---|---|---|---|
| 系统吞吐 tok/s(最大 batch) | 5,733 | 4,944 | 5,351 |
| 单请求吞吐 tok/s(batch 1) | 445 | 284 | 370 |
| 相对基座 AR 的加速 | 1.6× / 2.5× | — | — |
| 新增参数 | 0.35B | 0.40B | 1.05B |
| 峰值显存 GiB | 122.2 | 130.0 | 130.1 |
论文里 from-scratch 8B 模型的 headline:相对基座 AR 最高 3×,在设备支持的最大 batch 下也有 2×。质量方面,8B 的 Uno 在 agentic tool use、代码、长上下文推理上全面超过 26B 的 DiffusionGemma 和闭源的 Mercury 2。三分之一参数的模型正面打赢,值得把方法部分再读一遍。
还有一个容易被忽略的数字:DFlash 的 drafter 是 1.05B 参数——3 倍于 Uno 的适配器,而且训练时需要的上下文长度是 B·L,Uno 恒为 2·L。Draft model 不只是运维负担,也是训练成本负担。
真正做得好的地方
先给 credit,执行层面很 senior:
- 论文、权重、代码全开源。 Claim 可验证——K2 Horizon 发布时立的规矩,用在了自己的后续工作上。
- 在真实的 batch size 下评测——这是论文自己提出的要求,Uno 在最大 batch 下依然领先,而 d-LLM 的加速比恰恰死在那里。这是业界一直在呼吁的评测纪律,作者自己做到了。
- 训练成本低到真实可用。 0.35B 适配器参数,32 张 H200 训 32 小时,相对预训练只是零头。这意味着一个团队真有可能给自己的微调 8B 模型做一套,不需要 research 级预算。
诚实的 caveat
- “无损”和 speculative decoding 的保证是同一档。 都是 AR-verified 的拒绝采样,保住目标分布。论文自己都不报告无损方法的 accuracy——”差异只来自采样随机性和数值不确定性”。新的是机制(架构内置适配器、不要 draft model),不是保证本身。谁把这包装成”第一个无损加速”,谁就没读懂。
- 2.5×/3× 的 headline 是相对没加速的基座 AR。 对打最好的 draft model(DFlash),UnoQwen 系统吞吐 +7%,单请求 +20%。是实打实的赢,不是改朝换代。如果你家 speculative decoding 已经跑得很顺,这是升级候选,不是火警。
- 只验证了一个模型类别、一个规模。 全是 8B。适配器要给每个基座单独训——14.7B token、上千 H200 小时,对实验室是零钱,但不是零,跨模型家族的泛化还没证明。
- 尚无独立复现。 写这篇文章时,这些是 IFM 的数字、IFM 的 harness。做容量规划时当上限用,别当计划数用。
周一早上做什么
- 如果你在生产环境用 speculative decoding(8B 级别模型): 花一个 sprint,在你的流量、你的 p50 batch size 上,把 Uno 的适配器配方和你现在的 draft 方案对打。只有持续吞吐提升 ≥15% 且质量持平才换。低于这个数,重新训练和上线折腾不值那几个百分点。
- 如果你在给新部署选加速方案: 先把 draft model 的总成本算进去——训练、对齐、版本管理、和 target 同步、第二份 KV cache。Uno 真正的优势不是 1.6×,而是把这一整行删掉。任何基于 draft model 的方案,现在都得赢过架构内置适配器足够多,才配得上它的运维面。
- 容量规划铁律: 在你自己的硬件和流量上复现之前,任何厂商的最大 batch 吞吐数字先打 75 折。论文的数字是诚实的,但那是人家的硬件、人家的 harness、人家的最优配置。
辩论
如果一个 0.35B 的架构内置适配器无损、共享 KV cache、在所有 batch 下打败专用 draft 模型——那还有什么理由继续训练单独的 draft model?Speculative decoding 的双模型时代,是不是已经结束了?
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀