
模型没学,是规则手册学会了:Memento 3 与权重之外的记忆
Published:
一个冻结的 Claude Opus 5 刚刚在 ARC-AGI-3 上拿到了 100.0 分——比它自己的原始成绩高出 59.3 分。权重一动没动,变的是一个 agent 在游玩过程中不断重写的 Markdown 文件。
这是 Memento 3 的核心结果。作者是 Haoyu Zhao、Zhengxu Yu、Zhiyuan He、Meng Fang、Rasul Tutunov、Haitham Bou-Ammar、Weilin Luo、Jun Wang,来自 UCL、华为诺亚方舟实验室(英国)和利物浦大学,论文于 2026 年 10 月 8 日发布在 arXiv 上。这篇论文真正的贡献不是分数本身,而是一套让学习发生在权重之外的具体架构——以及一组异常诚实的表格,精确标明了其中有多少功劳真正属于这套架构。
发生了什么
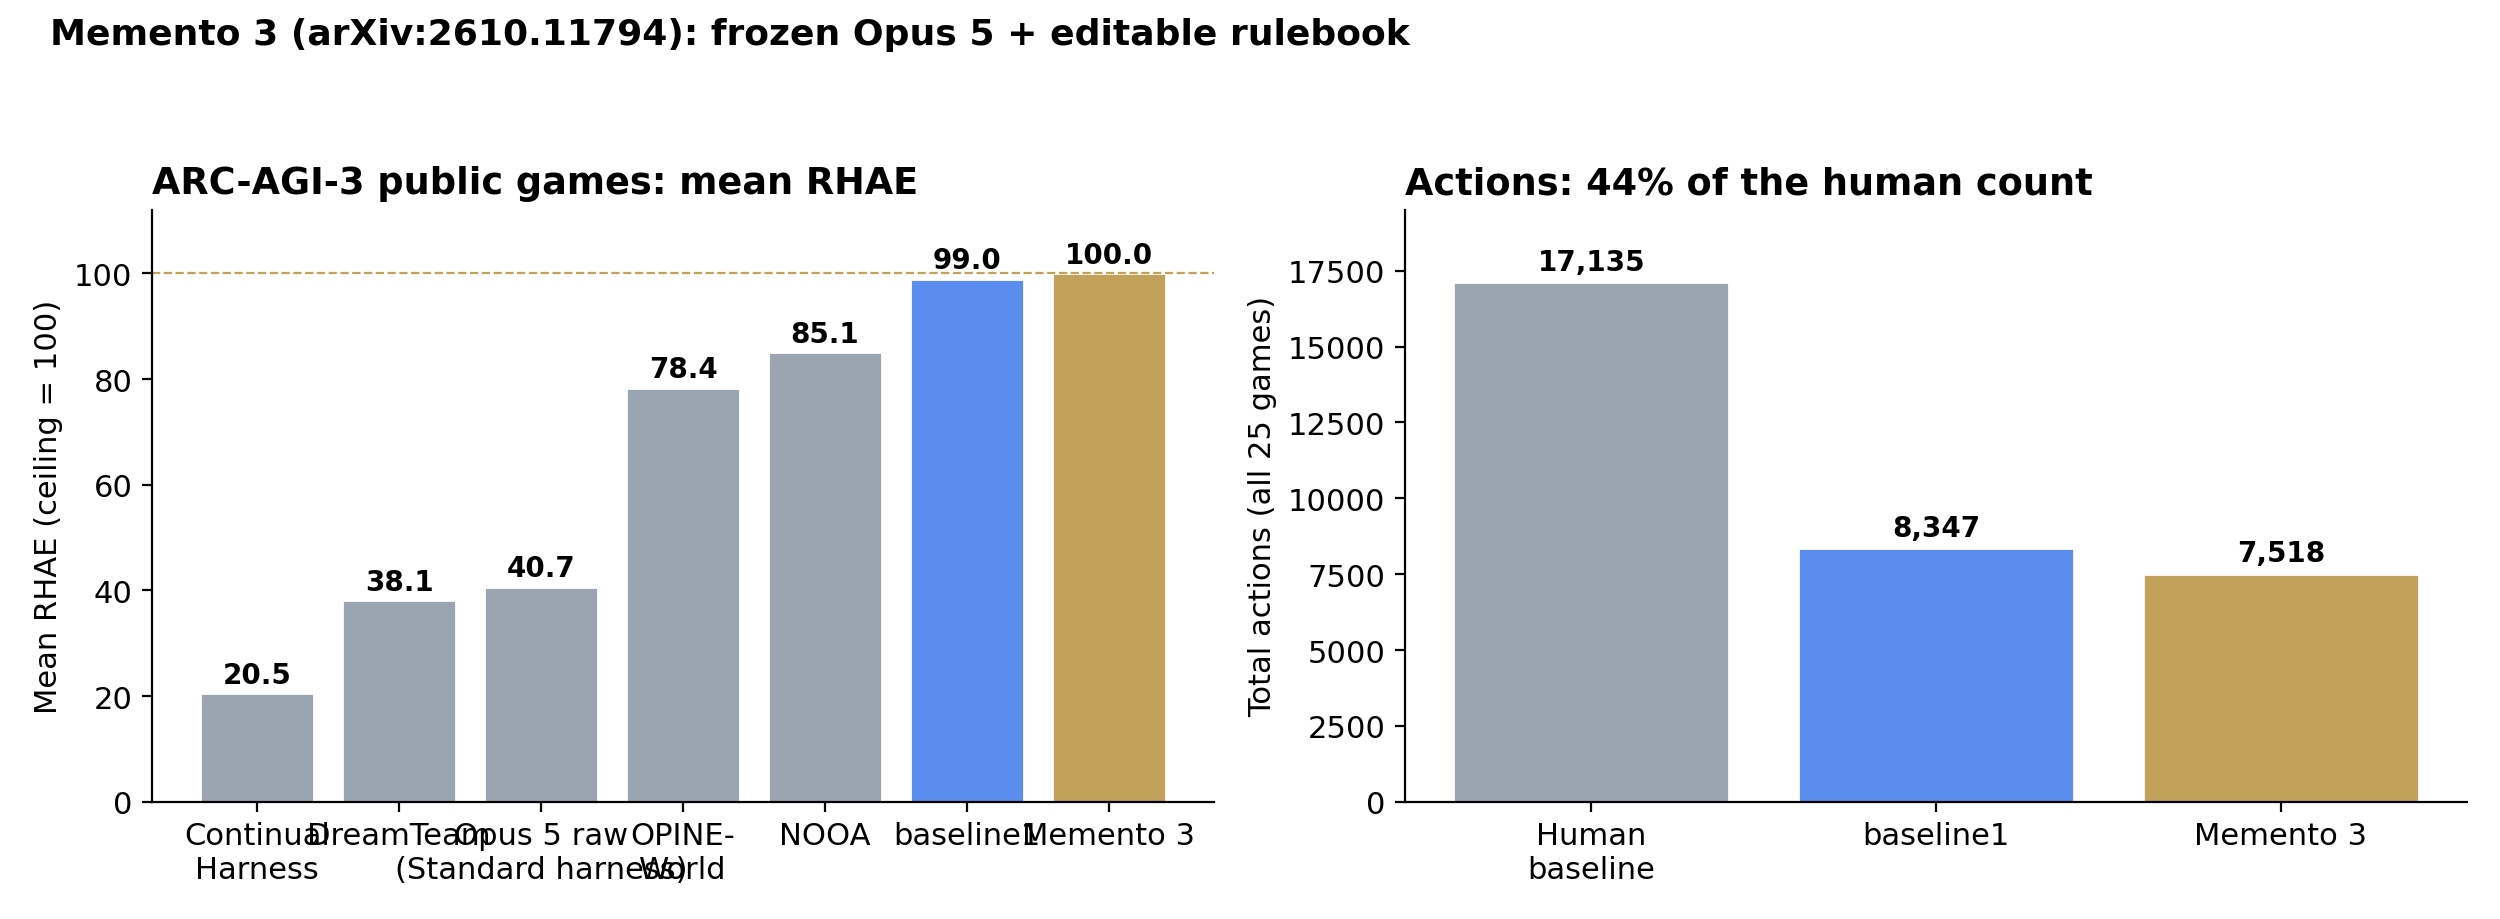
在全部 25 个公开 ARC-AGI-3 游戏上,单模型 Memento 3 agent:
- 通关了每个游戏的每一关,达到平均相对人类动作效率(RHAE)上限 100.0。
- 总共用了 7,518 个动作,是人类基准 17,135 个动作的 44%(单游戏比值 0.20–0.67,中位数 0.42)。
- 比 ARC Prize Standard harness 下的原始 Claude Opus 5(40.7 平均 RHAE)高出 59.3 分。
底座模型是在 Claude Code 里以 extra-high 推理强度运行的 Claude Opus 5。所有 baseline 数字都来自各自的官方 ARC Prize 记分卡,统计口径一致。
机制:Code as Model(代码即模型)
Agent 对世界的信念用两套表征来维护:
- 自然语言规则手册(一个 Markdown 文件)——持久的语义记忆,存放关于物体、动作、动力学和目标的可修正假设。未知部分刻意保持欠指定(underspecified)。
- 由规则手册编译出的可执行 Python 模块——用于预测和规划。
循环是:观察 → 反思 → 修改规则 → 编译 → 验证。规则层面的改动先写进规则手册,再去改代码;纯实现层面的诊断则保持规则手册不动,只修代码。
两次验证决定一次更新是否被接受:
- 精确回放(cell-exact replay):可执行模型必须复现交互历史里的每一次观测到的转移。这是硬门槛。
- 规则手册忠实度:由 LLM 自己判断代码是否忠实于规则手册。这是软门槛——同一个模型给自己的作业打分,这一点值得明说。
还有两个设计选择与循环本身同等重要:
- Git 记忆。规则手册和编译出的模块放在一个版本控制的工作区里,每次迭代后提交。Agent 可以查看早期版本、diff 两个版本的规则手册、恢复被后续编辑搞坏的可执行文件。学习轨迹是可寻址的,而不只是最新快照。
- 种群(Population)。同时维护 N 个规则手册–可执行文件对,共享同一份交互历史。不同模型引导探索;任何与观测冲突的模型都会被修复。这是对版本空间(version space)问题的直接回应:有限证据下,许多假设都能解释过去、却对未来预测不同,而过早押注其中一个会把探索引向远离能证伪它的证据的方向。
Pong 案例:同一套机制能做控制
ARC-AGI-3 是离散规划。论文进一步问:同一套基于规则手册的学习机制能否支撑反馈控制——即根据新观测持续更新决策?在 Atari Pong(ALE,frame-skip 4)中,学到的模型驱动一个反馈控制器:
- 三个不同开局的评估回合全部 21:0 获胜(分别用了 3,358 / 4,014 / 5,039 个动作)。
- 学习成本 9,504 帧——对比 EfficientZero V2 的约 400,000 帧(约 42 倍),无模型 RL baseline 的 2 亿帧(约 21,000 倍)。
- 同一个 LLM、没有世界模型、每帧调一次、无持久记忆,得分 −19。人类平均分是 14.6。
- 评估时控制器是固定的,零 LLM 调用——知识已经完全从模型里编译出来,放进了规则手册 + 代码。
诚实解读:规则手册到底带来了多少
这里是这篇论文赢得信任的地方——也是粗心总结会夸大其词的地方。
+59.3 的差距是相对于原始模型,而不是相对于领域现状。最接近的已有系统 Rodionov 的 baseline1 已经达到 99.0 RHAE,通关全部 25 个游戏,用了 8,347 个动作。Memento 3 相对于最强已有 harness 的优势是 +1.0 RHAE 和少 10% 的动作(7,518 vs 8,347)。baseline1 同样维护一个持久、经过验证的 Python 世界模型,论文的相关工作部分明确写了这一点。Memento 3 在此之上的增量是自然语言规则手册层、种群扩展、Git 记忆和 Pong 控制迁移——而不是代码世界模型这个想法本身。
消融实验很小。去掉规则手册(保持代码模型、验证器、harness、底座模型完全一致)只在 3 个游戏上测试(每个难度带一个):617 vs 677 个动作(−9%),678 vs 830 个 agent 回合(−18%),完成率保持不变。真实,但只是 3 个游戏的消融;论文也坦言每次运行成本很高。
种群结果只有一个游戏。N=2 只在 wa30(人类基准最大的游戏)上跑过:899 → 597 个动作(−34%),RHAE 保持 100。一个游戏、一次对比——有前景,未确立。
只有公开游戏。全部结果都在 135 个环境的基准中的 25 个公开游戏上。论文没有 held-out 或私有集的结果。Table 1 里的每个系统都是在同一批公开游戏上测的,所以对比是公平的——但“解出 ARC-AGI-3”指的是公开集,不是整个基准分布。
成本未披露。论文提到每次 Claude Code 运行都有“可观的时间和金钱成本”,但没有报告 token 或美元数字。动作效率不等于成本效率:一个用更少环境动作、却在每次修正时都烧 extra-high 推理强度的 agent,仍然可能是更贵的那一个。不要把“人类动作数的 44%”解读成成本节省。
周一早上该有什么不同
1. 给有状态的 agent 一本持久规则手册 + 一个回放验证器,而不是更长的 prompt。如果你的 agent 接触有状态环境(代码库、基础设施、数据 pipeline),它的持久状态应该是一份人类可读的规则文件 + 一份该环境的可执行模型,外加一个硬门槛:模型更新只有在精确复现全部已记录转移时才能上线。让 LLM 判断自己的代码是否忠实于自己的规则手册是软门槛——可以保留,但绝不能是唯一的门槛。触发阈值:一周内同一个 agent 失败第二次重复出现,就该上这套东西。只活在上下文里的教训,每个会话都要重新学一遍,而且按全价付费。
2. 把“重学成本”当作一个指标来记。统计你的系统花了多少 agent 回合去重新推导它以前已经推导过的事实。Memento 3 的消融给这个模式标了价:规则手册在测试游戏上省了 9% 的动作和 18% 的 agent 回合。自己跑一个版本:选一个反复出现的工作流,记一周花在已知事实上的回合数;任何重复出现两次以上的教训,都提拔为一条经过验证的规则手册条目。如果重学占 agent 回合的 ~15% 以上,瓶颈是记忆层,不是模型。
3. 当一个假设主导了探索,就在共享证据上并行跑两个世界模型。种群技巧——N=2、共享历史、冲突即修复——在唯一测试的游戏上把动作数砍了 34%。适用于单个早期假设主导整个轨迹的场景:保留两个互相竞争的模型,让它们分歧,让共享证据杀死错的那一个。在自己的任务上测出 N=2 的实际收益之前,不要为 N>2 付费。
可辩论的主张
如果一个冻结模型 + 一本可编辑、有版本管理的规则手册能匹敌重训,那模型就不再是全部产品。版本化的世界模型——可检查、可 diff、可回滚、可用回放验证——才是。重训是把知识放进读不懂的权重里;规则手册是把知识放进能审计的文本和无需模型即可执行的代码里——Pong 控制器正是证明。
反方观点同样真实:这一切都建立在一个前沿模型之上——它负责提出、修正和评判。规则手册只会和写它的那个冻结大脑一样好,而自我评判的软门槛是一个坏修订可以穿过的漏洞。Memento 3 没有消除这种依赖,它只是让这种依赖变得可审计。
Caveats 汇总
- 作者自报的 preprint,未经独立复现。全部 baseline 数字来自官方 ARC Prize 记分卡。
- 仅 25 个公开游戏;无私有/holdout 评估。
- 消融:3 个游戏。种群:1 个游戏。Pong:1 个游戏、3 个回合,且学习在第一次 21:0 获胜时即停止。
- 未报告 token 或美元成本;动作效率 ≠ 成本效率。
- 忠实度门槛是 LLM 评判自己的代码。
来源
- Memento 3: Model-Based Recursive Self-Improvement through Reflective Rulebooks — arXiv:2610.11794(2026 年 10 月 8 日提交):https://arxiv.org/abs/2610.11794
- ARC-AGI-3 基准论文 — arXiv:2603.24621:https://arxiv.org/abs/2603.24621
- 本文所有数字均来自 Memento 3 论文的 Table 1–5 和第 4–5 节,另有说明的除外。
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀