
换个 Harness 能买到什么?大多只是 Token——还有账单
Published:
几乎每周都有编码 Agent 厂商宣布:改了一版 Harness,pass rate 又涨了几个点——新系统提示、类型化文件工具、自动压缩、更聪明的循环。然后排行榜把这些「模型+Harness」的组合分数当成模型分数来排。10 月 23 日,Artificial Analysis 上线 Coding Agent Index v2.0,做的正是这件事:290 个任务上的模型+Harness 组合分。而山东大学的一篇论文在 10 月 23–24 日的广泛讨论中问了一个更靠前的问题:把模型固定住、只换 Harness,那些分数里到底有多少是 Harness 的?
这篇论文是 What Does a Harness Buy? Tokens, Mostly(arXiv:2610.04433,2026 年 10 月 3 日提交),作者是山东大学的 Yangze Liu 与 Zhongyi Han。答案就在标题里。而它难以被轻易反驳的原因在方法:作者做了大多数 Harness 对比都省掉的那个对照——把完全相同的配置重跑一遍,先量清楚「什么都不变时,分数自己会动多少」。
实验设置
- Harness 按出厂状态、版本锁定: Claude Code 2.1、mini-SWE-agent 2.4.6(只有一个 bash 工具,除硬停外没有任何上下文管理)、OpenCode 1.18。
- 模型: 五个开放模型——Qwen3.6-35B-A3B、Qwen3.8-27B、DeepSeek-V4-Flash、GLM-5.3-Flash、HY4-Preview——外加只在 Claude Code 里运行的锚点模型 Claude Opus 5。
- 基准: SWE-bench Verified,分成 45 题的困难子集(最难的两个难度档,正是 Harness 理应最起作用的地方)和 447 题的大池——后者才是这项研究能 bound 住小效应的统计功效来源。
- 计费: 每一臂都按同一张价目表、用各自的 token 数计价,成本对比是同口径的。
发现一:换 Harness 翻转的任务数,和重跑一次一模一样
在 45 道困难题上,换 Harness 让中位数 13% 的任务结果翻转。而把同一个 Harness 重跑一遍,同样翻转 13%。对每个模型而言,三个 Harness 之间的 spread 只有 45 题里的 2 到 5 题,而重跑一个 Harness 自己就能动最多 3 题。更麻烦的是对排行榜来说:某个 Harness 这一轮赢下的题,下一轮赢的并不是同一批——这些「胜场」根本不可复现。
在 447 题的大池上,最重的 Claude Code 与最轻的 mini-SWE-agent 在两个模型上都等价于 5 个点以内。论文结论把分辨率说得很精确:按观测到的 discordance,45 题只能以一半的概率抓住 12.9 个点的差距、以 80% power 什么都抓不住;447 题能分辨约 5.2 个点。而大多数已发表的 Harness 收益——论文引言里某厂商宣称的是 2.4 个点——连 447 题的分辨率都够不着。
厂商用自家 Harness 跑自家模型也没有买到任何优势:DeepSeek 的 Harness 跑 DeepSeek-V4-Flash,在 45 道困难题里通过 21 题,和 Claude Code 相同、比 mini-SWE-agent 还少 1 题,账单反而排在最贵一档(每 trial 1.04 元人民币,对 Claude Code 的 0.98 元)。
发现二:唯一超过噪声的效应,是丢分
OpenCode 在大池的 Qwen3.8-27B 上落后 8 到 9 个点——这是整篇论文里唯一越过噪声线的 Harness 差距,而且方向全部一致:指向 Harness 在丢题。这个差距的一半,来自被它的输出上限中途截断、在写出 patch 之前就结束的运行。其余能叫得出名字的 Harness 失败全是同一类:上下文窗口硬停且没有压缩、撞上步数上限崩掉、搜索工具在离线环境跑不起来。
作者的总结值得原样引用,因为它重新定义了 Harness 工程的回报在哪里:「就这份证据而言,Harness 买到的是更少的丢题方式,和一张账单,而不是 pass rate。」以及:「我们能测到的每一个 Harness 效应,都是一种把模型本来能解的题弄丢的方式。」
一年前的 Claude Code 旧版(1.0.100)从反面说明了同一件事:它的通过数与当前对照运行只差 1 题以内,成本却是标价的 0.44 倍——因为它默认不开 extended thinking。一年的 Harness 版本迭代,动的是账单,不是分数。
发现三:账单在第一次调用时就定下了
同一个模型、同一批任务、同一张价目表,三个 Harness 的单任务成本最高差 3 倍。驱动因素不是工具返回了多少文本——每次调用,三个 Harness 交给模型的文本量大致相同。真正的差异是那段固定的 preamble:系统提示+工具 schema+消息包装,每个 Harness 在每一步都要重发一遍:
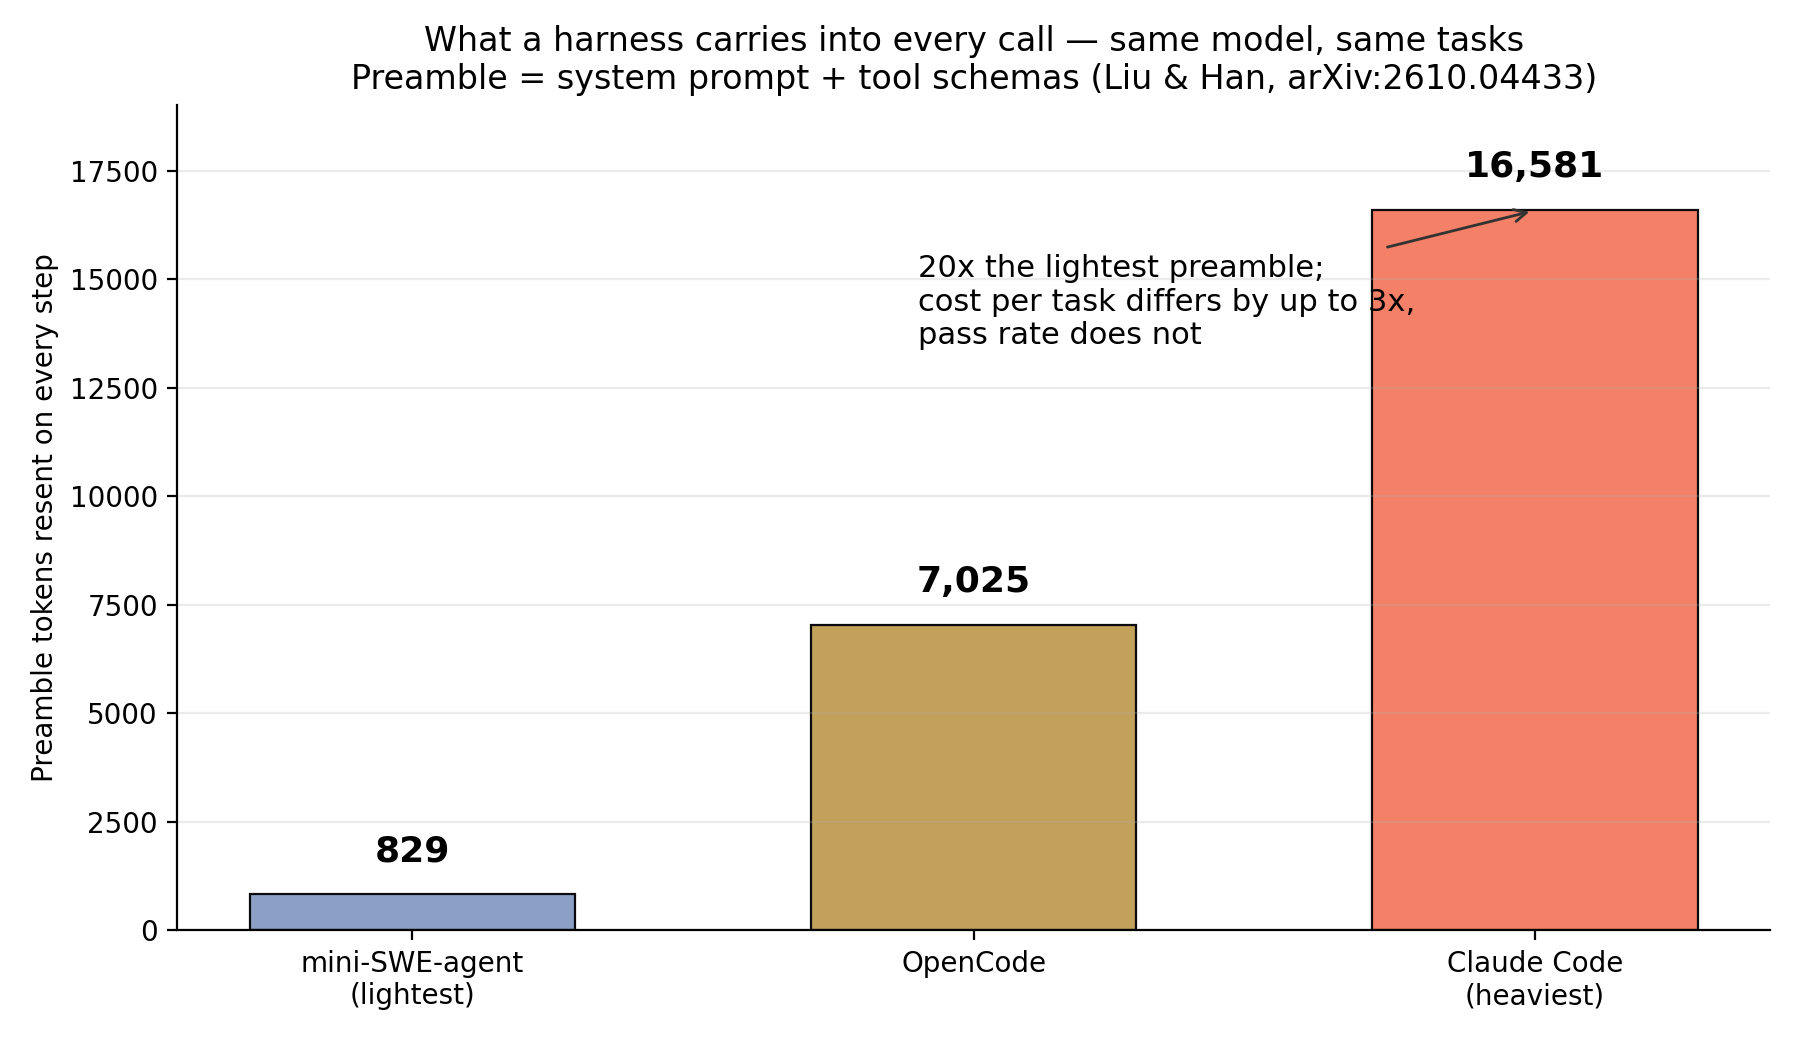
- Claude Code:16,581 tokens
- OpenCode:7,025 tokens
- mini-SWE-agent:829 tokens
在 GLM-5.3-Flash 上,三者的步数相近,于是每步重量就是全部故事:Claude Code 每 trial 1.81 元,mini-SWE-agent 0.97 元,OpenCode 0.56 元。换到 DeepSeek-V4-Flash,两个因子互相抵消——mini-SWE-agent 用了 141 步对 Claude Code 的 104 步,transcript 随每一步增长,最轻的 Harness 最后搬运的 token 反而最多。作者认为,跨厂商可携带的三个数字是:第一次调用的大小、每步增长率、总步数。
缓存也救不了这个排名:每一臂 96% 到 99% 的输入 token 本来就已经是缓存命中,把两家的价目表互换重算,Harness 的成本排序不变。缓存命中价只是缩放账单,不改变顺序。
唯一的线索:thinking 依赖是「模型+Harness」的属性
作者说唯一值得追下去的交互,是与显式推理(thinking)的交互。在 Qwen3.6-35B-A3B 上关掉 thinking,mini-SWE-agent 掉 11 个点(p = .04),而 Claude Code 与 OpenCode 的变化都在噪声以内。换到 HY4-Preview,同样是在 Claude Code 里关掉 thinking,掉的也是 11 个点——和该模型上最宽的 Harness 差距一样大——同时输出 token 砍掉一半以上。换句话说,对 thinking 的依赖属于「模型+Harness」这个组合,而不是模型本身。把一个 Harness 里的 effort 设置原样搬到另一个 Harness 里、指望行为一致,这条发现就是警告。
边界,必须说清楚
- 只有一个基准。 全部头条结果都来自 SWE-bench Verified;在 Terminal-Bench 2.1 上只有一个模型的迁移检验,通用 Agent 可能是另一个 regime。
- 闭源前沿基本不在场。 三 Harness 阶梯最高只到 HY4-Preview;Claude Opus 5 只在 Claude Code 里跑过,所以这篇论文回答不了闭源前沿模型是否也有同样的差距。
- 离线条件本身也是 Harness 变量。 OpenCode 出厂的搜索工具无法离线运行,这正是论文计数的「丢题方式」之一——作为产品观察是成立的,但读它落后幅度时要记得这一点。
- 这与协同训练的结果并不矛盾。 微软研究院的 Self-HPO(10 月 19 日)报告了 +7 个点(平均 resolve rate 57.8% → 64.8%):Agent 先重写自己的 Harness,然后模型在这个 Harness 里做 RL 训练。换 Harness 买不到东西;把模型训进 Harness 是另一个命题。两个结果放在一起,恰好把这条线画清楚了。
周一可以照着做的四件事
- 5 个点以下的 Harness 收益一律按平局打折,除非它是在 400+ 任务上、且旁边附了重跑对照测出来的。45 题的对比只有一半概率抓住 13 个点的差距——在小任务集上宣称的 2–3 个点不是证据,是带市场部的抛硬币。
- 试点之前先给 preamble 定价。 记录任何待评估 Harness 的第一次调用 token 数。如果它每一步都固定携带约 10,000 token 以上,先要求延迟加载工具或裁剪工具面再上线——这笔固定成本乘上步数,就是分数相同情况下最高 3 倍的账单差。
- Harness 工程的钱按这个顺序花在防丢上: 输出上限截断后的恢复(本研究里唯一被测到的分数效应)、上下文硬停之前的压缩、工具失败时大声报错而不是离线静默失效。先审计你失败运行里有多少以截断或撞上限结束;如果占失败的 5% 以上,先修这个,再碰提示词。
- effort/thinking 设置绝不跨 Harness 裸搬。 同一个开关在一个模型+Harness 组合里值 11 个点,在另两个组合里一文不值。任何 Harness 或 effort 变更后,重跑你自己的 30–50 题切片,而且跑两遍——一遍不叫测量。
我愿意为之辩护的论点是:Harness 不是能力层,是可靠性与成本层。它赢不下模型本来会输的题;它只会弄丢模型本来能赢的题,并决定每一步的单价。按这个定位去买它、测它、给它配人。
来源
- Liu & Han, What Does a Harness Buy? Tokens, Mostly, arXiv:2610.04433 — https://arxiv.org/abs/2610.04433v1(全文:https://arxiv.org/html/2610.04433v1)
- Artificial Analysis, Coding Agent Index v2.0 发布报道(2026 年 10 月 23 日)— https://aicoder.com/news/news-20261023-artificial-analysis-coding-agent-index-v2-frontiercode
- Microsoft Research Self-HPO 报道(2026 年 10 月 19 日)— https://explainx.ai/blog/self-hpo-harness-policy-optimization-coding-agents-microsoft-research-2026
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀