
最强研究 Agent 在真实互联网上只拿 39 分——却依然赢了人类
Published:
大多数网络搜索基准跑在冻结的网页快照上。这样做可复现,但永远摆脱不了一个质疑:答案是不是早就躺在训练数据里?2026 年 10 月 19 日提交到 arXiv 的论文《Deep Search in Real-World Web Environments》(arXiv:2610.30181,25 位作者,香港科技大学(广州)领衔)干脆把快照整个去掉——它的基准 OpenDS-World 让 agent 直接在真实、未修改的开放网络上做研究。
设定
OpenDS-World 包含 200 道任务,横跨文化、日常生活、科学、经济、历史、自然、社会、科技八个领域。每道任务从一段包含真实信息的视频出发,要求 agent 跨多个独立来源自行发现证据——来源横跨文本、图像、音频、视频等模态,HTML、PDF、XML、Parquet 等格式,以及七类交互式访问要求——最终收敛到一个唯一事实答案。任务经过独立人工校验,确保证据有效、答案唯一。12 个前沿模型在同一套工具环境与执行协议下评测,每道任务限时一小时、工具调用上限 100 次。
核心数字
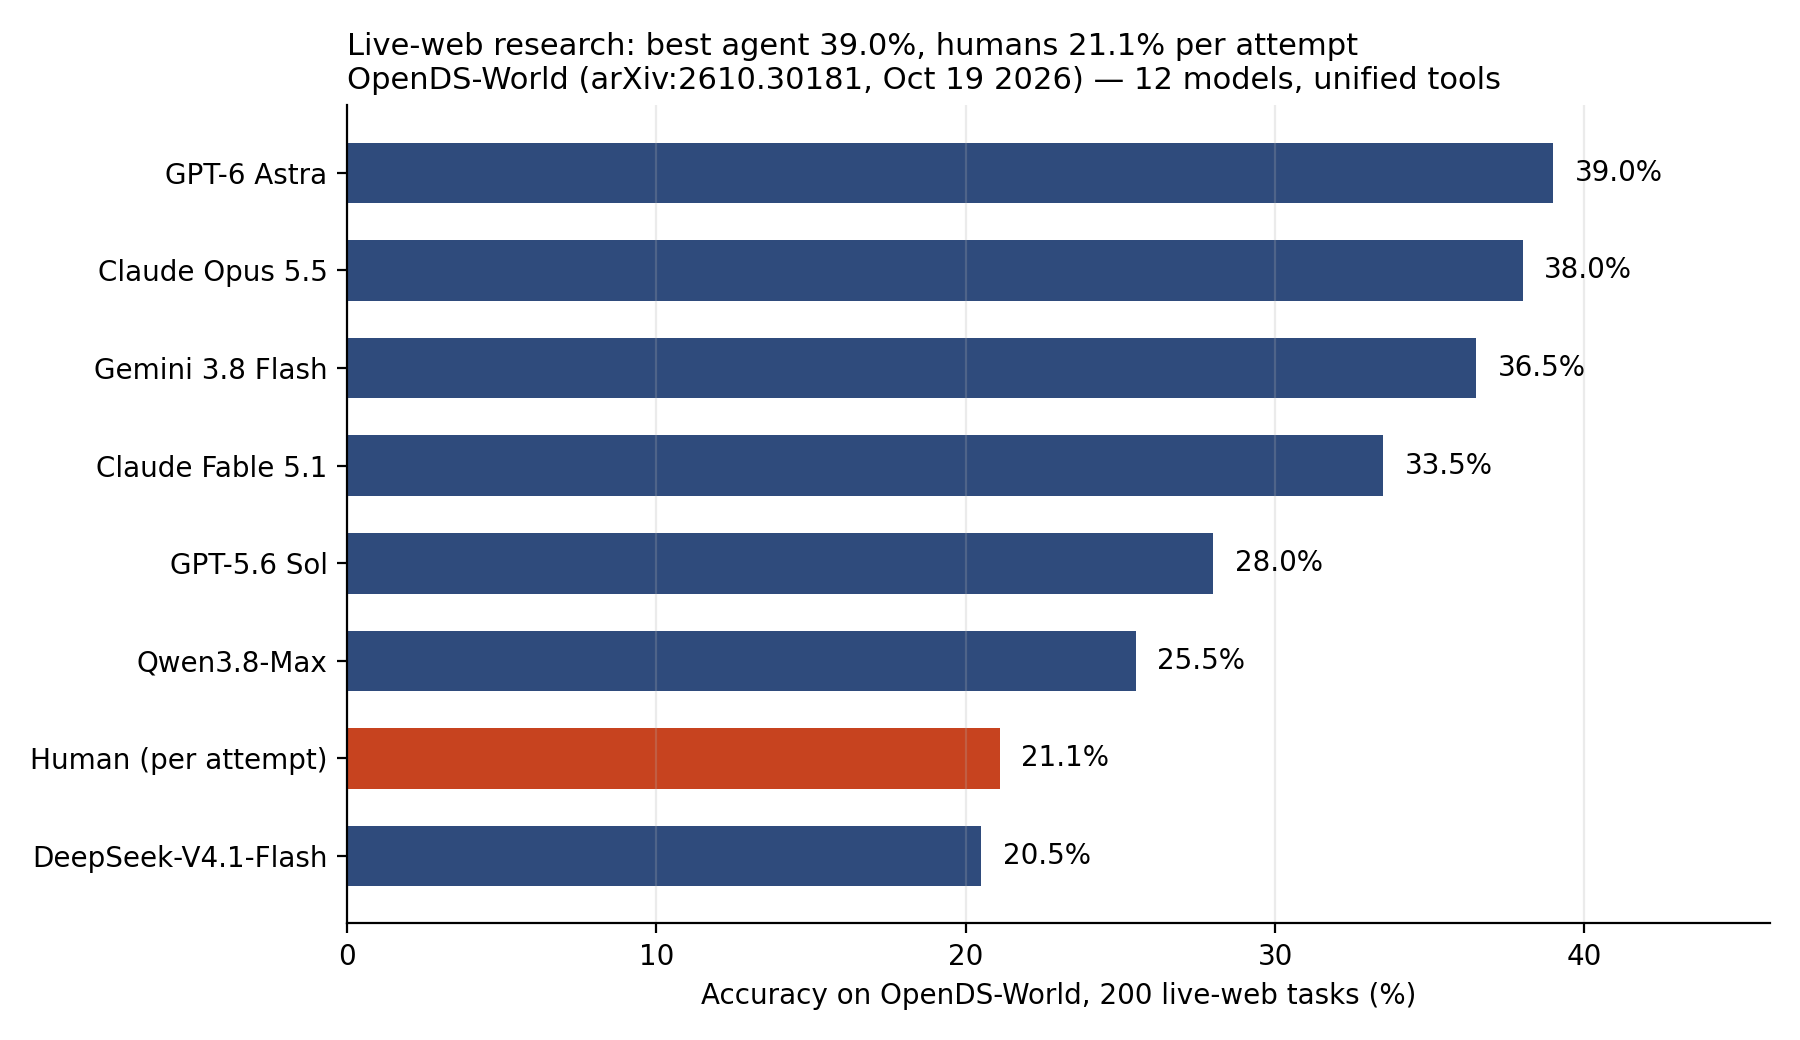
- GPT-6 Astra 以 39.0%(200 题中答对 78 题)居首,其后是 Claude Opus 5.5 的 38.0%、Gemini 3.8 Flash 的 36.5%、Claude Fable 5.1 的 33.5%。
- GPT-5.6 Sol 为 28.0%,Qwen3.8-Max 为 25.5%;其余模型在 23.5% 或以下。
- 人类参与者在 1,000 次独立尝试中的单次准确率为 21.1%;且有 42.5% 的任务,所有被分配到的人类都没能解出。
- 即便是最强模型,也做错了 200 题中的 122 题,失败率 61.0%。
先肯定该肯定的:真实网络设计是对的,统一工具环境消除了“工具不同、分数不可比”的常见混杂因素,用人类单次尝试做基线也比多数基准那种精挑细选的专家基线诚实。高出基线 17.9 个百分点,是实打实的结果。
但限定条件必须一并写清。这些任务本就是按“难”来构造的——42.5% 的任务难倒了每一位尝试的人类——所以这里的“agent 赢了人类”指的是“在对抗性高难研究题上,agent 赢了单独作答的人类个体”,而不是“agent 比你的分析师更会做研究”。另外,真实网络基准天然非平稳:页面会变、链接会失效,下个月重跑测的已经不完全是同一套题。这是消掉数据污染质疑必须付的代价,值得付——但分数应当被读作带日期的快照,而不是永久排名。
浏览得越多,不等于研究得越好
这篇论文最有价值的发现是个负结果:资源消耗买不来准确率。
- Gemini 3.8 Flash 消耗的 token 约为 GPT-6 Astra 的 5.22 倍,分数反而更低(36.5% 对 39.0%)。
- GPT-6 Astra 与 GPT-5.6 Sol 的总 token 消耗几乎相同,准确率却差了 11.0 个百分点(39.0% 对 28.0%)。
- GPT-6 Astra 平均每题 51.05 次工具调用、18.66 分钟;Qwen3.8-Flash 平均每题 89.94 次调用,在 80.0% 的任务上撞到调用上限,自然终止率只有 6.5%。
准确率还随难度陡峭下滑。12 个模型平均:低难度 39.66%,中难度 23.50%,高难度只剩 16.76%。GPT-6 Astra 从低难度的 59.26% 跌到高难度的 24.71%。
隐藏税:失败的工具调用
失败调用占比不高,代价却惊人。在各模型中,失败调用只占全部调用的 2.83%–9.42%,却吃掉工具执行时间的 19.27%–61.90%。以 GPT-6 Astra 为例:占调用数 6.34%,占工具时间 42.57%。头部模型在失败后最常见的动作是切换工具(Claude Opus 5.5 约 83%、Gemini 3.8 Flash 约 81%、GPT-5.6 Sol 约 79% 的失败后决策);弱一些的模型则把预算耗在原地重试上。
终止本身也是个陷阱。GPT-6 Astra 在 69.0% 的任务上自然终止,但答对的只有 39.0%——“自信地停下”和“答对”是两回事。任何把“agent 停了”当作“agent 成功了”的生产系统,都在把这 30 个百分点的差距原样搬进线上。
周一我会做的三件事
- 给搜索设上限,而不是给模型设上限。 在你自己的 20 道真实网络任务切片上,记录每道题的准确率与工具调用数。如果某套配置平均每题超过约 50 次调用、却没有比更精简的配置高出至少 5 个百分点,就上线精简的那套——OpenDS-World 的 token 数据表明,过了这个点,多花的量是支出,不是信号。
- 显式给失败留预算。 失败调用不到 10% 的调用数,却能吃掉高达约 62% 的工具时间。定一条硬规则:同一工具最多带新参数重试 2 次,之后切换工具或中止轨迹并升级处理。这正是前三名模型约 80% 时候在做的事。
- 把“停下”和“答对”分开计分。 在评测面板里把“自然终止率”和“答对率”做成两个指标。若两者差距超过约 20 个百分点,你的问题在停止判断与证据整合,不在检索——加再多搜索预算也修不好。
诚实的总结:在真实存在的开放网络上——格式混乱、页面要交互、证据散落在各处——我们手里最强的 agent 答对率是 39%,而这已经接近单个人类独自作答的两倍。要补的差距不是努力程度,而是判断力:去哪找、何时换、何时停。
来源
- Yu et al., Deep Search in Real-World Web Environments, arXiv:2610.30181, 2026 年 10 月 19 日提交 — https://arxiv.org/abs/2610.30181
- 全文与表 1(各模型准确率、难度分层、token 消耗)— https://arxiv.org/html/2610.30181v1
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀