
你的 AI 研究员预测不了实验结果——但它可以记住
Published:
AI 研究员现在可以自己提想法、写代码、跑训练、评结果,循环已经闭环了——除了其中一步,一直没人好好量过:模型在跑实验之前,能不能判断这个想法值不值得跑?
十月的两篇论文从两个方向回答了这个问题,合在一起结论很干净:零样本直觉又弱又系统性缩水;往实验记录里看,才是比换模型、加推理都更有效的升级。
第一篇论文做了什么
Bansal 等人(Autolab AI、Institute of Foundation Models、MIT)建了一个 288 个 LLM 提出想法的实验数据集,覆盖 8 个 MLE-bench Lite 任务:3 个用 log loss 评分(spooky 作者识别、狗品种识别、树叶分类),3 个用 ROC AUC(tabular playground 2022 年 5 月、毒性评论分类、random acts of pizza),2 个用 RMSE(纽约出租车费、脏文档去噪)。基线取在各任务公开排行榜中部附近,想法既有空间变好、也有空间变坏。
每个想法由同一个模型提出并实现:从基线出发提 4 个想法,每个新解再提 2 个跟进想法——每棵树 12 个想法,8 个任务 × 3 个提议模型(GPT-6 Astra、Claude Fable 5.1、Kimi K3)× 12 = 288 个想法。排除 19 个(运行失败或无可用预测),剩下 269 个用于分析。一半想法被要求改进分数,一半被要求让分数变差——都是认真的提议,不是故意搞破坏,这样结果能覆盖两个方向。
然后 5 个前沿模型对每个想法预测结果,推理强度拉满,输入包括任务、当前代码与分数、想法和代码 diff。每个任务的结果按实际变化的标准差(σ)归一化,符号翻转使正值恒为改进。
核心数字
| 预测模型 | R² | 斜率 | 方向准确率 |
|---|---|---|---|
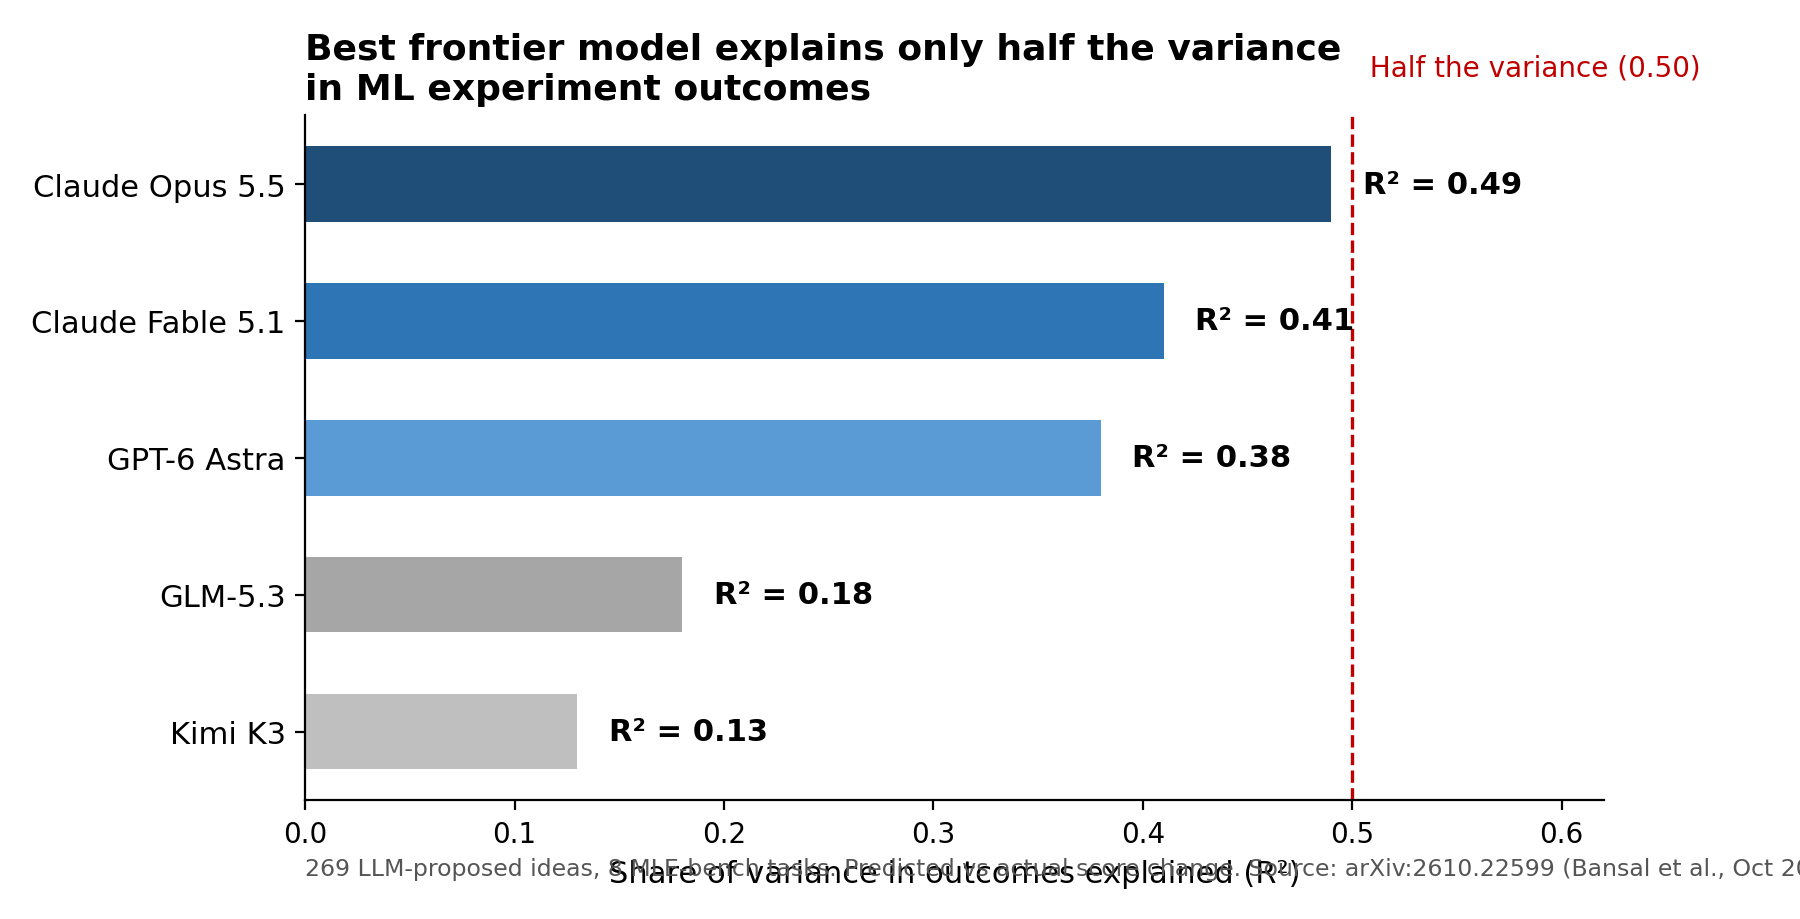
| Claude Opus 5.5 | 0.49 | 0.61 | 82% |
| Claude Fable 5.1 | 0.41 | 0.57 | 78% |
| GPT-6 Astra | 0.38 | 0.56 | 76% |
| GLM-5.3 | 0.18 | 0.25 | 72% |
| Kimi K3 | 0.13 | 0.21 | 69% |
三个结论值得注意。
第一,最好的模型也只能解释一半方差。 按论文的高斯模型,Opus 5.5 排第一的想法平均能拿到最佳想法增益的约 70%;Fable 5.1 为 64%,GPT-6 Astra 为 62%,GLM-5.3 为 42%,Kimi K3 为 36%。用来做初步筛选够用,离”替代跑实验”还差得远。两个开源权重预测器(GLM-5.3、Kimi K3)基本只比噪声强一点。
第二,所有模型都在系统性缩水现实。 五条拟合线的斜率全部低于 1.0,所有模型都低估了大变化的幅度。真实 +2σ 的改进,在 Opus 5.5 的预测里只显示为约 +1.2σ,在 Kimi K3 里只显示为约 +0.5σ。如果你拿模型的原始点估计去排计划、做预算、定路线,你会系统性地低估大赢——和大输。
第三,方向比幅度可靠得多。 Opus 5.5 的方向准确率是 82%;排除小变化(±0.25σ 以内,方向可能只是训练噪声而非想法质量)后,所有模型的准确率进一步上升。信方向,别信大小。
预测质量随任务剧烈波动
汇总数字掩盖了方差。Opus 5.5 在毒性评论分类上 R² = 0.94,在狗品种识别上只有 0.39。GPT-6 Astra 在 tabular playground 任务上 0.81,在树叶分类上 0.02。两个图像任务——狗品种识别和脏文档去噪——最难:最好的模型也只有 R² = 0.39 和 0.43。
这个数字应该终结一切”一个预测器分数”的叙事。在文本/表格任务上看起来能干的模型,在视觉任务上可能近乎无用,反之亦然。任何把 LLM 当实验守门员的团队,都需要按任务家族分别校准,而不是看一个 headline R²。
什么有用,什么没用
加推理有用——只对强模型。 从最低到最高推理强度,Opus 5.5 从 0.35 → 0.49,Fable 5.1 从 0.31 → 0.41,GPT-6 Astra 从 0.28 → 0.38。Kimi K3 和 GLM-5.3 几乎不动。给弱预测器花最高推理的钱是白花。
加上下文有用——主要对最强模型。 去掉代码 diff 会拖垮三个最强的模型。加数据卡加前 20 行数据只对 Opus 5.5 有帮助;只有 Opus 5.5 从”只有想法”到”完整提示”的整体提升明显超出噪声。上下文不是免费升级——它是能力门槛型的升级。
实现者几乎不重要。 在另外一组 66 个想法上,Fable 5.1 和 Kimi K3 分别实现,58 个落在彼此 0.25σ 以内,25 个得分完全相同。表述精确的想法谁实现都一样;例外是开放式想法(比如”用哪些额外数据”留给实现者决定),或者某次实现失败。预测之所以定义良好,是因为实现大多不是瓶颈。
没有自我偏好。 模型对自己想法的残差平均只比其他模型在同一想法上的残差高 +0.01σ(95% 区间 −0.06σ 到 +0.08σ)。模型不会系统性偏爱自己的提议——在满是评判自我偏好发现的文献里,这是一个令人安心的零结果。
修复方法:给预测器一个记忆
同一周,Wang 等人(Amazon、UC Santa Cruz、Emory、Penn State、UC Santa Barbara)测试了硬币的另一面:预测器拿到过往实验记录而非只有当前任务时,会发生什么?他们的评估基于 9 个研究环境的 2,600 多条实验记录,涵盖预训练、后训练和推理,超过 171,000 H100 GPU 小时的实验。
结果是第一篇论文的镜像:
- 来自真实实验经验的研究知识,能改善对同一环境中未见干预的预测(Spearman +0.27)。
- 它能跨环境迁移:仅用 OLMo3、Marin、Nanochat 的预训练经验,研究世界模型在 Qwen3 环境中的选择遗憾比零经验设定降低了 78%。
- 在固定选择预算的多轮自动研究中,环境内和跨环境的研究知识分别把取得的最佳增益提高了 15.8% 和 11.6%。
- 在 13 个语言模型的消融中,加入研究知识对干预排序的改善,超过换模型或增加推理努力。
两篇论文一起读,架构就出来了:预测器不是产品,实验日志才是。零样本直觉上限是 R² = 0.49;扎根于你自己运行历史的预测器,打败换模型,也打败加推理 token。这也重塑了第一篇论文自身的框架——作者指出,先前工作发现基于过往结果微调的模型预测最好,而 Wang 等人同时证明过往记录能改善预测。第一篇论文量的其实是冷启动情形。而真正跑实验的人,不该一直待在冷启动情形里。
周一早上做什么
1. 绝不让零样本分数单独决定一个想法的生死。 每个进入队列的自动提议必须带两样东西:模型的预测变化,以及你自己日志里至少 3 个最近的过往运行(同一任务家族或同一干预类型,附实际结果)。日志里没有过往运行 → 想法进便宜的试点通道,不进主队列,也不进垃圾桶。
2. 把每一次运行——包括失败——记成结构化记录。 一个只追加的账本:想法、代码 diff、配置、相对基线的 σ 单位结果、随机种子、成本。每周对照账本重排 backlog。第二篇论文的教训是,这个账本不是记账负担;它是预测器最高杠杆的输入。在某个任务家族积累约 20 条记录后,就别再冷启动评估预测器了——带着账本上下文评估它。
3. 用方向做 go/no-go,别用幅度——而且要纠正缩水。 把模型的符号当作弱信号(最好情况约 82%),把点估计当作缩水过的数字:非要用它做计划,就把预测幅度按约 1/0.61 ≈ 1.6 倍放大(对最好模型而言),并放宽误差棒。永远别拿未纠正的点估计去定训练预算。
局限
第一篇论文的局限写得很直白,而且很重要。每个想法只跑了一次,所以每次测得的变化都有一部分是训练噪声,完美预测器的上限未知。8 个任务都是小 ML 问题,不是 LLM 训练运行——R² = 0.49 能否推广到预训练或大规模 RL 未经验证。而且研究预测的是单个想法,不是想法序列;一个单步预测平庸的模型,多步搜索的导航能力可能仍然不错(或更差)。第二篇论文的环境是 LLM 研究环境,更接近前沿用例,但仍不能证明任何团队的内部日志都会有 78% 的遗憾降低——那是一个跨环境演示,不是保证。
即便如此,联合结论经得起这些保留:没有记忆的预测,在困难任务上就是带额外步骤的抛硬币;而记忆是整个技术栈里最便宜的能力升级。如果你要做自动研究,先建账本,再建预测器。
来源
- Bansal, Pareja, Klein, Didenko, Lukoianov, “Can LLMs predict the outcomes of machine learning experiments?”, arXiv:2610.22599,2026 年 10 月 15 日提交 — https://arxiv.org/abs/2610.22599
- Wang et al., “Language Models as AI Research World Models”, arXiv:2610.12235,2026 年 10 月 8 日提交 — https://arxiv.org/abs/2610.12235
- 第一篇论文发布的数据集:https://github.com/autolab-ai/EV-estimation
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀