
企业 Agent 不是输在检索,是输在版本冲突
Published:
一句话结论
企业 Agent 最主要的失败原因,不是找不到记录,而是工作区里的记录互相矛盾——模型必须判断到底哪个版本说了算。
MMEnterprise-Bench 于 2026 年 10 月 20 日以预印本形式发布(arXiv:2610.27911),测的正是这个场景:工作记录被分享、被纠正、被修订,而且旧版本不会被覆盖删除,而是留在库里。
这个基准是怎么搭的
- 1,613 道题,来自 30 个模拟协作项目,种子材料是公开论文和报告。
- 一个共享工作区语料共 7,140 条检索记录,其中 1,415 条是视觉记录(PDF 页面、幻灯片、独立图片),其余是聊天、邮件、会议纪要、追踪表、报告和文档。
- 三大类:证据推理 1,102 题(抽取、归因、计算、比较、解读);冲突消解 424 题(跨来源 212 题、时间演变 212 题);不可回答 87 题(把一道可回答题目的某个实体或条件改掉,让任何记录都支撑不了答案)。总计 1,526 题可回答、87 题不可回答。
- 共评测了 10 个闭源和开源多模态大模型。
读数字前要先看评测协议:用 Qwen3-VL-Embedding 检索器(默认 2B,另有 8B 版本)对 7,140 条记录排序,取 top-k 按时间戳和 ID 顺序呈现给模型,再由一个 LLM 裁判(GPT-5.6 Luna)把回答和参考答案对比。准确率是对全部 1,613 道题统计的。
断崖:同一个模型,证据形态一变就崩
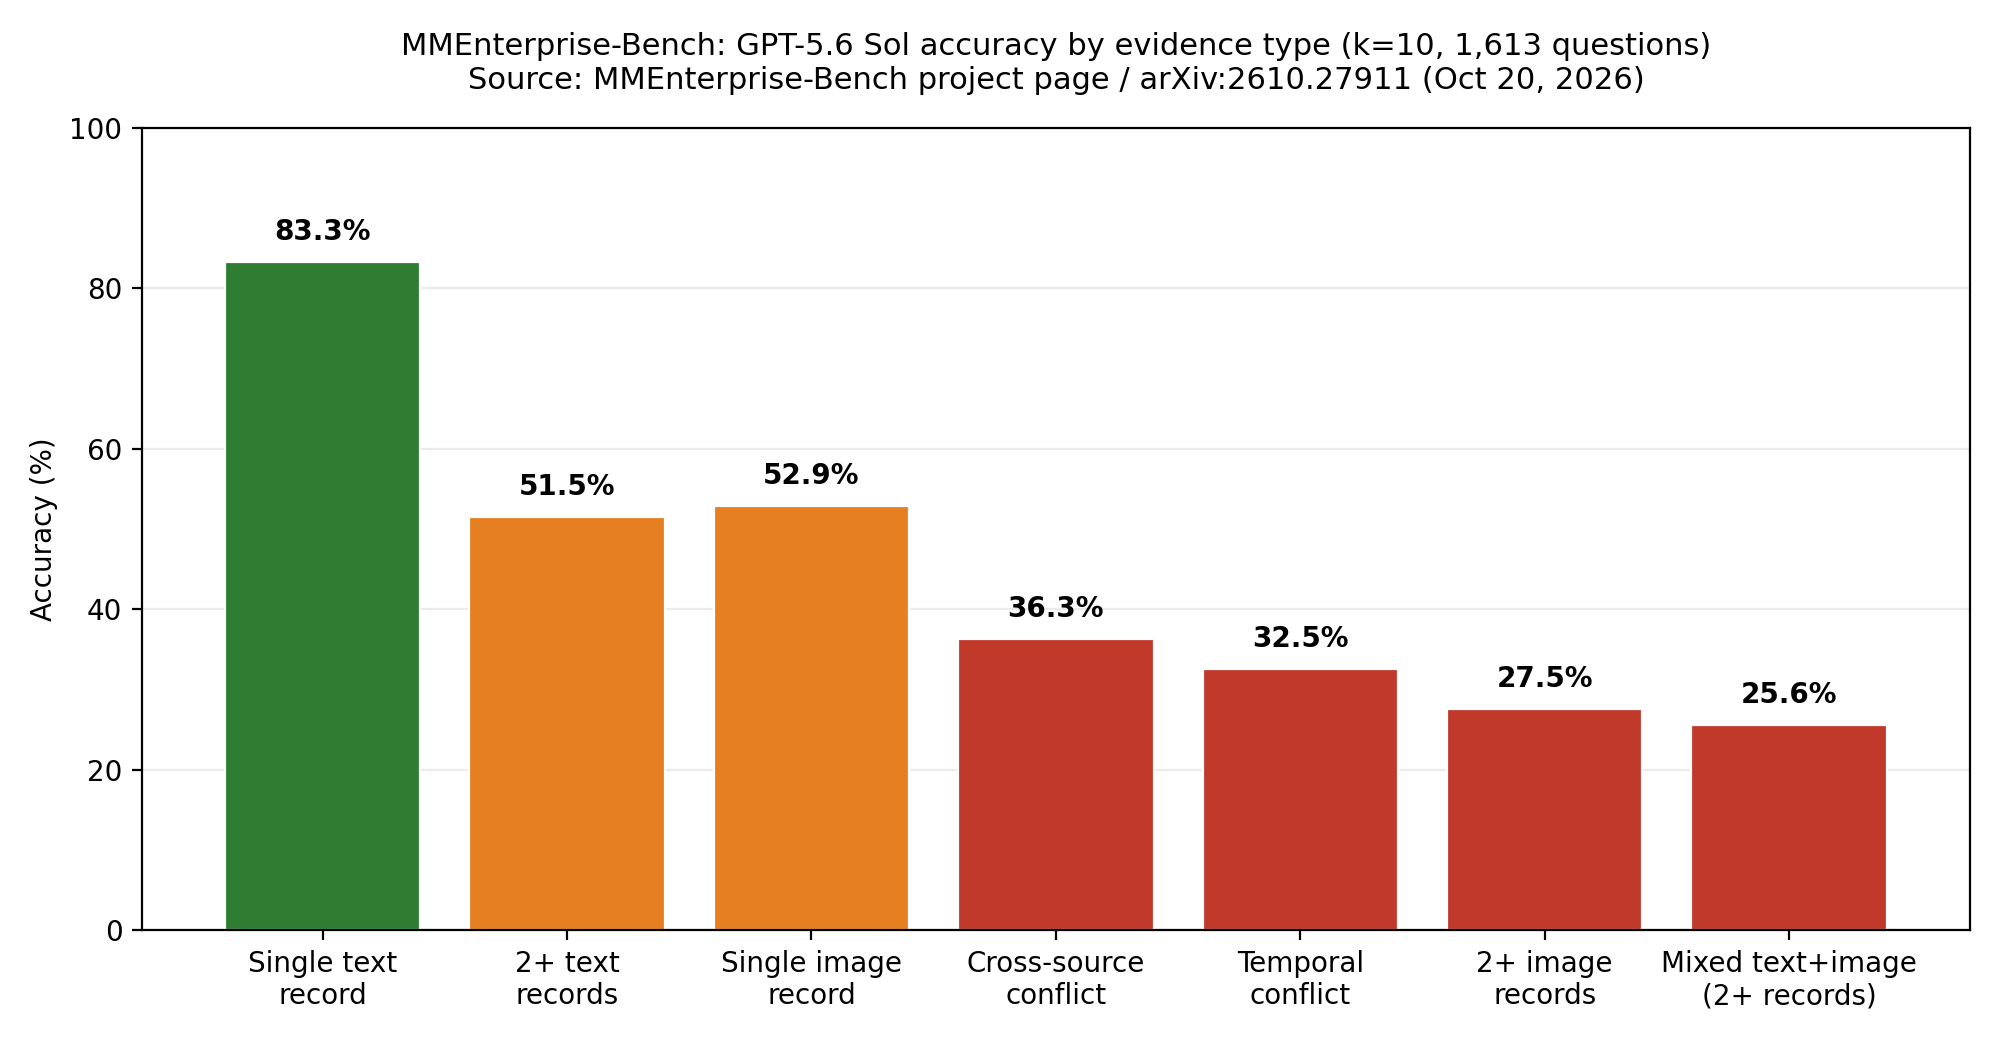
最强模型 GPT-5.6 Sol,在默认 k=10 下:
| 证据形态 | 准确率 |
|---|---|
| 单条文本记录 | 83.3% |
| 2 条以上文本记录 | 51.5% |
| 单条图片记录 | 52.9% |
| 跨来源冲突 | 36.3% |
| 时间演变冲突 | 32.5% |
| 2 张以上图片 | 27.5% |
| 文本+图片混合,2 条以上 | 25.6% |
同一个模型、同一个基准、同一天:「答案就在一条干净文本里」和「答案横跨多张图片」之间,差了 55.8 个百分点。
总体上,Sol 在 k=10 是 52.6%,k=50 是 68.0%。最好的开源模型 Qwen3.5-27B 在 k=50 是 50.3%。没有谁接近天花板,而错误恰好集中在真实工作区最乱的地方:k=10 时冲突消解只有跨来源 36.3%、时间演变 32.5%,而普通抽取有 67.5%。
加大检索确实能抬高冲突分数——k=50 时 Sol 的跨来源升到 55.2%、时间演变升到 56.1%——但仍比同 k 下的抽取分数(77.6%)低约 20 个百分点。检索能缩小差距,关不掉差距。
召回率不是准确率
这篇论文最可迁移的发现,是关于「检索」这根杠杆本身的:
- k 从 50 提到 100,证据召回率 Recall@k 从 57.0% 升到 64.8%(2B 检索器;k=10 时是 41.3%)。
- 但 Qwen3.5-2B 的总体准确率却从 k=50 的 25.0% 跌到 k=100 的 22.2%——上下文里对的证据更多了,答案反而更差。
- 更大的 8B 检索器能再加召回(k=100 时 67.3%,2B 是 64.8%),但用作者的话说,对准确率的提升「并不稳定一致」。
对前沿模型来说,加 k 是有用的:Sol 用 2B 检索器在 k=10、50、100 下分别是 52.6%、68.0%、75.9%。所以诚实的说法不是「检索没用」,而是:检索扩容的效果取决于模型,而且就算有效,冲突消解仍然是最低的那一档。 如果你的仪表盘只盯召回率,你就会一直为最容易量化的那根杠杆买单。
不可回答题的反转
还有一个数字值得记住:在「判断一道题根本没法从记录里回答」这件事上,总体第一名不是最强的模型。k=10 时,Gemini 3.8 Flash 在不可回答类拿到 87.4%,GPT-5.6 Sol 只有 65.5%。推理最强的模型,反而更愿意去回答一个没有证据支撑的问题。在企业场景里——一个截止日期、一个数字、一个审批——自信地给出过期或编造的值,比拒答更糟。
注意事项,说清楚
- 项目是模拟的:协作事件由 LLM 规划,再基于公开种子文档生成合成的聊天、邮件和幻灯片。这不是对任何真实公司部署效果或员工产出的测量。
- 打分用的是 LLM 裁判(GPT-5.6 Luna),不是对 1,613 个答案逐一人工评分。
- 质量控制是验过的,不是假设的:三位标注者对 100 条标注做盲审,71% 无人驳回、29% 至少被一人驳回;LLM 接受的 50 条没有一条被标注者驳回,而被人驳回的 29 条也全部被 LLM 检查驳回过。
- 上文 headline 数字除非特别说明,都是 k=10、2B 检索器下的结果。换 k,绝对数值会动,但失败模式的排序不会变。
周一可以做什么
- 用你自己被修订过的文档,搭一个 50 题的冲突测试集——25 题跨来源(同一事实、不同来源说法不同)、25 题时间演变(同一事实、后来被改过)。你的通用 QA 评测藏起来的正是这一档。
- 设 60% 的门槛。 如果 Agent 在生产 k 下这个测试集低于 60%,冻结检索预算和检索器升级。你现在还不是检索问题,是优先级问题。
- 先加明确的版本优先级规则,再加上下文:最新时间戳优先,除非某个具名来源等级更高;并要求答案引用那条取代旧值的新记录。验证到底是规则、而不是更大的 k,在抬冲突分数。
- 召回率和冲突准确率分两条线记。 如果召回连涨两轮、冲突准确率纹丝不动,就别再往检索上花钱了——这正是 MMEnterprise-Bench 的模式在你自己栈上的复现。
- 拒答能力单独计分。 如果你最强的模型比便宜模型更爱回答无证据的问题,就把低证据问题路由给更会拒答的那个模型,而不是总分更高的那个。
可以争论的论点
大多数企业 RAG 的预算分配是反的:钱花在找更多证据上,失败却来自对已找到证据的裁决。在 Agent 能说清它信了哪个版本、为什么之前,更大的上下文窗口只是更大一堆矛盾。
来源:MMEnterprise-Bench 论文与项目页(arXiv:2610.27911,2026 年 10 月 20–21 日发布)。
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀