
把 Agent 装进瓶子里:60 次尝试中 48 次输给了自己的零样本成绩
Published:
任何把 LLM 跑在数百万条相似数据上的团队——相关性标注、工单分类、字段抽取——最后都会问同一个问题:这么重复的任务,为什么还要按前沿模型的价格逐条付费?最自然的解法,是让强 agent 自己动手做那个廉价替代品:训练一个小模型,或者写一个可复用的程序,一次投入,然后大规模运行这个工件。
Sonthalia、Puerto、Rubinstein、Gubri 和 Oh 的新基准 BOTTLED(arXiv:2610.08775,2026 年 10 月 6 日提交)测的正是这个能力。作者称之为”装瓶”(bottling):把通用能力转化成在质量与摊销成本之间平衡的任务专用方案。
测试方法
Agent 拿到一整批无标注的工作负载,外加固定的时间、算力和 LLM API 调用预算。它可以自由选择策略——蒸馏小模型、写程序,或其他办法——最后在全量负载上评分。研究共 10 个模型、3 个任务、60 次装瓶运行,并把每次运行与两个参照对比:同模型自身的零样本成绩,以及同等 token 预算下的两个小模型蒸馏基线。
头条结论是失败率
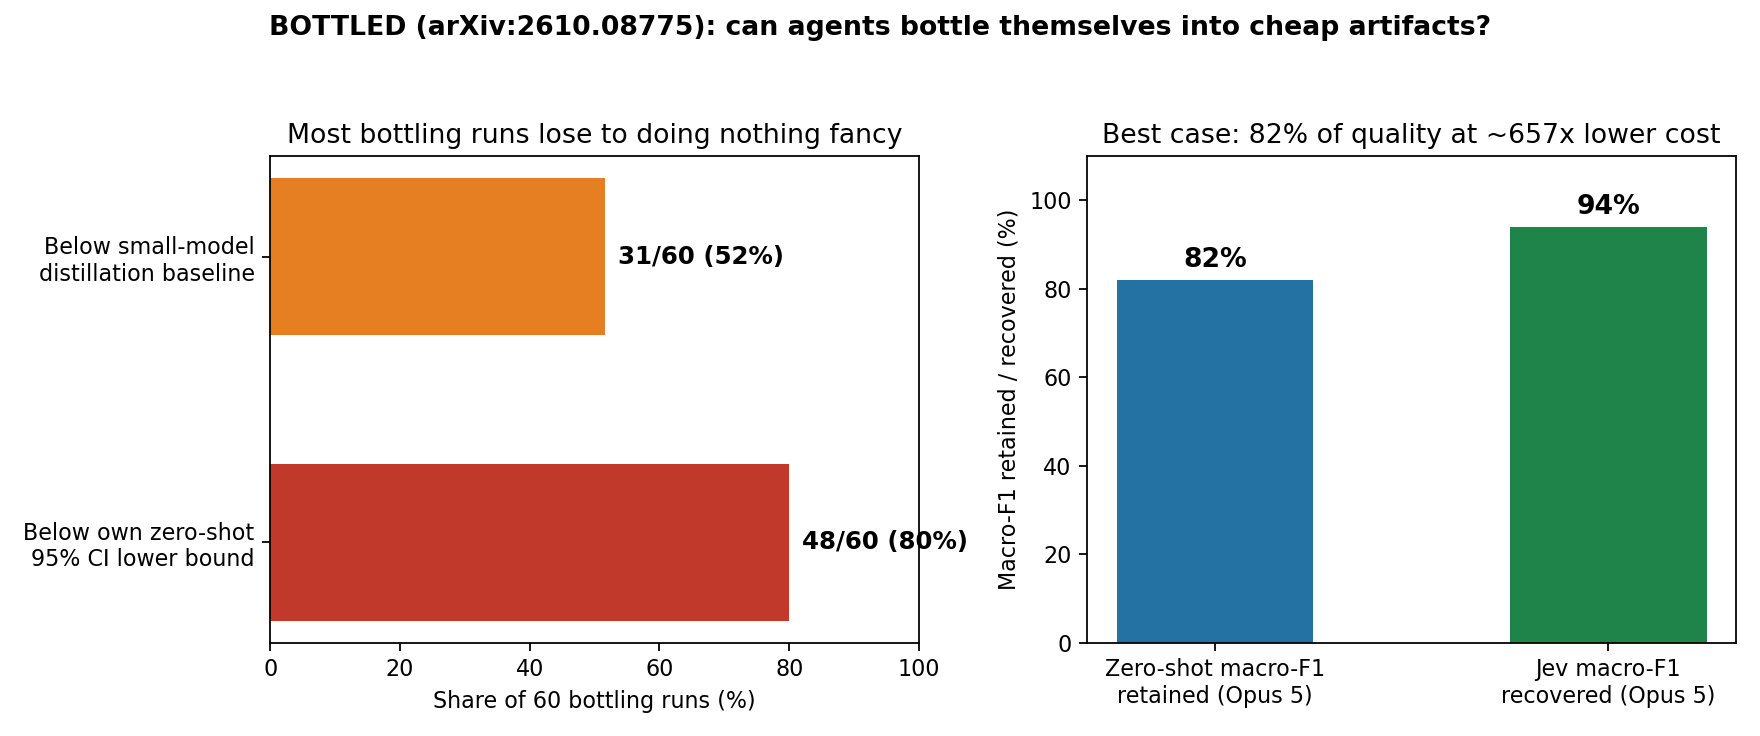
- 60 次运行中 48 次(80%)低于自身零样本成绩 95% 置信区间的下界。说白了:五次里有四次,那个”优化过的”工件还不如直接调模型。
- 60 次中 31 次(约 52%)输给了同等 token 预算下更强的那个朴素蒸馏基线。Agent 不只是输给零样本——一半时候输给了它本该打败的无聊基线。
- 零样本成绩相近的模型,装瓶后差距显著拉大。零样本排行榜预测不了装瓶能力;这是一项独立的能力,而今天它基本不存在。
但成功时,收益巨大
在查询–商品相关性分类任务上,论文报告 Opus 5 的装瓶工件以约 657 倍更低的报告成本,保留了约 82% 的零样本 macro-F1。对照 Jev——一个专为廉价重复推理设计的”系统一”模型——同一工件以 Jev 全量 projected 成本的四分之一,拿回了约 94% 的 macro-F1。
这才是真正的故事:装瓶的期望收益很高,但命中率很低。它是一个组合下注,不是一个默认优化动作。
周一可以做的三件事
- 先用调用量设门槛。每季度同类调用低于约 100 万次,不要装瓶——摊销算不过来,直接调前沿模型,把工程时间花在别处。
- 先跑无聊基线。任何 agent 碰负载之前,先用同等 token 预算训好朴素蒸馏基线。在 BOTTLED 里它 60 次赢了 31 次;agent 过不了这条线,就上线基线。
- 提前写好止损规则:工件在留出集上至少保留 90% 的零样本质量、且单次成本不高于原来的 1/50,才保留;否则回滚到直接调用,把这次尝试记为一笔便宜的实验。
留给行业的问题
如果装瓶是一项独立技能——把固定预算投资成可复用资产,而不是回答下一个 prompt——我们是不是应该直接为它建基准、做训练,而不是假设它会从通用能力里自动涌现?BOTTLED 的答案是:它不会涌现。谁先显式地训练它,谁可能就掌握高调用量推理的经济学。
来源:Sonthalia 等,《Agent in a Bottle: Can LLM Agents Turn Their Capabilities Into Cheap, Scalable Artifacts?》,arXiv:2610.08775(2026 年 10 月 6 日)。以上数字均来自论文摘要,为作者报告的结果。
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀