
前沿没有秘方——只有 5,000 倍算力
Published:
问题
每家实验室都声称自己有独门绝技。MIT FutureTech 团队问了一个更实在的问题:这种优势在数据里真的存在吗——还是前沿进展本质上只是训练规模变大了?他们的答案发表于 2026 年 10 月 14 日的同行评审期刊《npj Artificial Intelligence》:两者都存在,但作用在不同层级。规模主导前沿,效率主导前沿之下的所有一切。
研究方法
研究覆盖 2022 年 10 月至 2025 年 3 月发布的 809 个模型,以归一化 MMLU-Pro 分数衡量性能。训练算力按标准公式计算(6 × 参数量 × token 数)。回归模型把每个模型的性能拆成四部分:规模(对数训练算力)、共享算法进步(发布时间效应)、开发者特有效率(开发者效应,即所谓”秘方”),以及模型特异残差(其余一切:微调、专项优化、训练运气)。
样本包括 10 家主要开发者——DeepSeek、Qwen、Meta、Google、Microsoft、OpenAI、Anthropic、xAI、01.AI 和 Nvidia——以及若干小开发者群体。MATH Level 5 上的复现作为稳健性检验。
前沿的发现
- 规模对前沿性能的解释份额从 77% 升至 88%(从第一期的最佳模型 Llama 70B,到最后一期的 GPT-4.5)。在反事实分解中,仅规模一项就能解释前沿性能的全部提升。
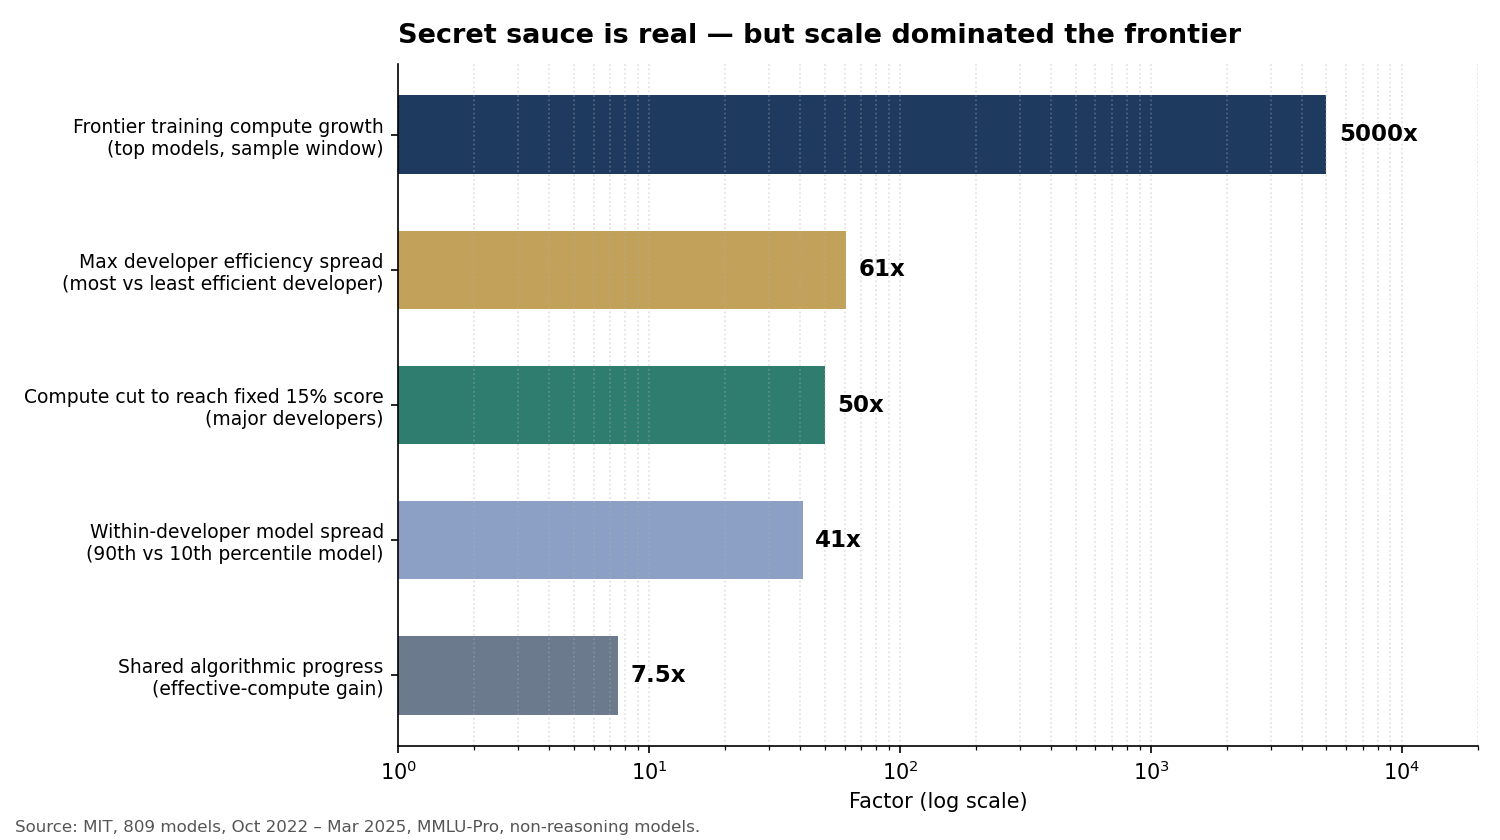
- 头部模型的训练算力在样本窗口内增长了约 5,000 倍——远远超过作者估计的任何效率因子。
- 在控制时间和开发者效应后,算力增加 10 倍,性能的对数几率提高 0.79。
- 在全部 809 个模型中,规模解释了 32% 的性能差异(主要开发者中为 45%)。公司效应在主要口径中占 14–18%,在不同样本切分中为 14–34%。共享算法进步仅解释 3–10% 的跨模型差异——作为方差份额很小,但作为水平提升很大(见下文)。模型特异残差占 32–47%。
前沿之下的发现
这才是这篇论文真正有意思的地方——也是大多数买家和建设者实际所处的位置:
- 共享算法进步使有效算力提升了 7.5 倍:用 2023 年初的技术达到 2024 年底的性能,需要 7.5 倍的算力。在 MATH Level 5 上,这一增益是 11 倍。
- 开发者之间的效率差距高达 61 倍。 在控制时间和规模后,最高效的开发者用单位算力换到的基准性能远高于最低效的开发者。
- 同一家公司内部的差距可以超过 40 倍。 模型层面残差——同一开发者、同一时期——在 MMLU-Pro 上 90 分位与 10 分位之间相差 41 倍,在 MATH Level 5 上相差 186 倍。数据配方、微调选择带来的差异,即使在同一实验室内部也极其巨大。
- 达到固定能力所需的算力崩塌式下降。 要达到 15% 的归一化 MMLU-Pro 分数,主要开发者所需的算力下降了 50 倍(计入小开发者则为 8,000 倍)——而该阈值上的分数反而从 16.6% 微升至 18.0%。
简言之:专有技术和共享进步几乎不改变前沿排行榜,但它们是把给定能力压缩进更小、更便宜模型的全部故事。这种压缩很可能就是推理价格下降的一大原因。
为什么这种分化是合理的
在前沿,所有人都能获得大致相同的公开算法思想,约束条件是谁能负担最大的训练。而在前沿之下,约束条件翻转了:能力目标是固定的,赢家是谁用最少的算力达到它。效率是复利——更好的数据、更好的配方、更好的微调——它表现为 50 倍的成本差距,而不是 2 个点的基准差距。
引用之前先看局限
- 数据截止于 2025 年 3 月。 这是 2026 年 2 月预印本的同行评审发表,不是新的测量数据。新闻点是同行评审本身。
- 仅限非推理模型。 10 个推理模型被排除,因为数据没有涵盖推理时算力。前沿结论属于前推理时代的训练规模时代。推理时代——推理算力成为第二个规模轴——是否会推翻这一结论,是一个开放问题,论文没有回答。
- 主要是一个基准。 MMLU-Pro 承载主要结论,MATH Level 5 作为稳健性检验。两者都不是 agent、编程或劳动力市场相关的评测。
- 闭源模型的前沿算力是估计值。 大型专有模型的参数量和 token 数来自第三方估计,存在显著不确定性。作者在排除这些观测后重新运行了分析,并报告定性结论保持不变。
- 开发者效应是平均值,不是宿命。 开发者之间 61 倍、开发者内部 41 倍的差距意味着,模型卡片上的厂商标签远不如具体模型背后的配方有预测力。
周一怎么做
- 把 AI 预算拆成两条线,用不同的采购规则。 前沿押注按算力获取能力定价。产品层模型按单位能力算力定价:在你的评测上达到你的质量门槛所需的 FLOPs(或美元)。如果供应商说不出第二个数字,就不要以高于现有支出的价格续签产品层合同——拿能过你的质量线的最便宜模型去比价。
- 在买更多算力之前,先审计自己内部的 90–10 差距。 用最好和最差的配置/配方跑同一个任务,测量效率差距。如果最优与最差相差超过 10 倍,先修复配方方差——数据配比、微调、解码、检索——再花钱买更大的训练。论文说单个实验室内部的差距可达 41 倍;你的团队也不例外。
来源
- Mertens, Fischl-Lanzoni & Thompson, “Is there ‘Secret Sauce’ in large language model development?”, npj Artificial Intelligence (2026), 2026 年 10 月 14 日发表:https://www.nature.com/articles/s44387-026-00159-2
- 完整结果的预印本(arXiv:2602.07238v2):https://arxiv.org/html/2602.07238v2
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀