Naive-N0.5-Flash:百万上下文不需要全注意力,但 2,122 tok/s 需要打 42 折
Published:
北京的 NaiveAI 刚发布了 Naive-N0.5-Flash:309B 参数的 MoE 模型,激活参数只有 15.5B,原生支持 100 万 token 上下文,权重按 MIT 协议开源——而且据我所知,这是第一个在全网 48 层里彻底去掉全注意力(full attention)的同规模模型。论文 BibTeX 标题叫 “Building Frontier AI with AI”,发布博客的 headline 是 2,122 tokens/秒。
这两半宣传都值得细读。一半是真突破,另一半是”如何阅读厂商数字”的教学案例。
真正新的东西
先说架构。全网 48 层 transformer 全部是局部或稀疏注意力:39 层滑动窗口注意力(128 token 窗口)+ 9 层 DeepSeek 稀疏注意力(轻量 indexer 给全历史打分,backbone 只 attend 得分最高的 2,048 个 token)。8 个六层 module,大致按 5:1 的 SWA–DSA 比例排布。他们把原始 DSA 里的 MLA 换成了 GQA(4 个 KV group),自研的 16-head 轻量 indexer 比原始 DSA 实现的索引选择 wall time 少了 44%,同时在 1M 上下文的 agent 任务上保持了性能。
这件事的意义在于:全注意力一直被当作长上下文里”不可替代”的那部分。滑动窗口和稀疏注意力早就有了,但以往的模型总会留几层稠密全局注意力当安全网。Naive-N0.5-Flash 把安全网拆了——他们自己的说法是,在百万 token 上下文下,全局层占了解码开销的大头,于是直接转成稀疏并重训。这是一个存在性证明:在 1M 上下文、309B 规模下,稠密注意力是可选的,每 token 只激活约 5% 参数。
训练 recipe 的文档详细程度在工业界发布里也算少见。从小米开源的 MiMo-V2.5 base 出发,在原生 1M 上下文上跑了 3.25T token,分三阶段:
- Indexer warmup(500 亿 token):只训练新增的 DSA indexer,其余参数冻结;待转换的层暂时保留全注意力,用 KL 散度 loss 把 indexer 和 backbone 的注意力分布对齐。用稠密 teacher 给稀疏 retriever 做冷启动,干净的做法。
- 稀疏注意力 continued pretraining(3T token):切换到稀疏执行路径,固定学习率继续预训练,主攻 AI R&D 和代码能力。
- LR decay / SFT(2000 亿 token):保持稀疏执行路径做 SFT,同时把学习率降下来。
基础设施细节也给了不少:混合序列并行(DSA 层用 Ulysses,SWA 层用 halo 方案,把通信复杂度从 O(L) 降到 O(w))、细到单个算子输出的 activation offloading,以及在 1M 上下文配置下 512 张卡约 4 天跑完 1T token 的训练系统。致谢里也写明了站在谁的肩膀上——小米 MiMo 团队、DeepSeek 的 DSA 工作、SGLang。
42 倍的脚注
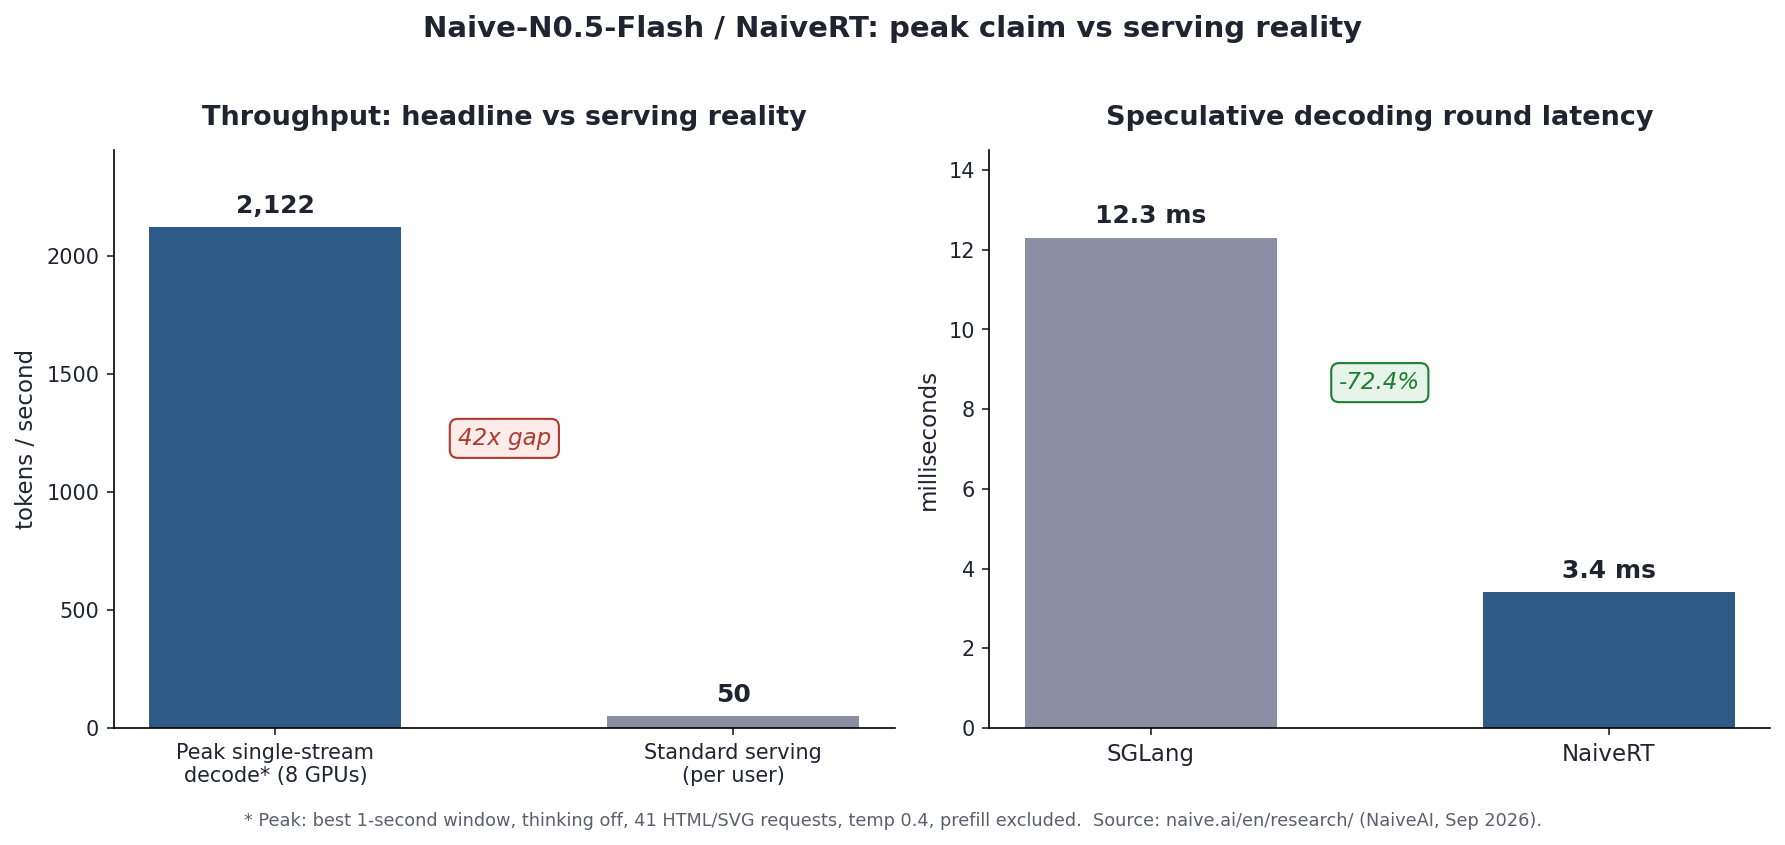
再看 headline 数字。”最高 2,122 tokens/s”是真实测得的、也如实披露了测量条件——但它是单流、纯 decode、取最好的一秒窗口,在 8 张卡上、thinking 关掉、41 个 HTML/SVG 生成请求、temperature 0.4,而且不含 prefill。他们自己写的 “Standard mode” serving 数据:每用户 50 tokens/s。headline 和实际拿到手的数字之间,差了 42 倍。
公允地说,NaiveAI 给出了一个诚实的机制解释:为什么对他们的工作负载单流速度才是该优化的指标。在 1M 上下文的 RL rollout 里,ingest 的 token 以 5,000–10,000 tok/s 进来,生成的 token 只有 50–100 tok/s——但生成 token 占了 60–80% 的 wall-clock,长 rollout 会变成 straggler,而 batching 缩短不了单条流。单流 decode 速度确实是 RL 的瓶颈约束。工程本身也是实的:一轮完整的 speculative decoding 从 SGLang 下的 12.3 ms 降到 3.4 ms(-72.4%),采样是 bitwise deterministic,保证 rollout 不会悄悄训成 off-policy。
但买 API token 的人,没有谁是在 8 张卡上跑单流 RL rollout。对其他所有人,有意义的数字是 50。结论可以推广:按 serving 数字定价,不按 benchmark 数字定价。
“AI 建造 AI”——但有人类 kill switch
“AI-centered R&D”是这次发布里最会被引用的一句话,值得既肯定又打折。
肯定:过程透明度少见。AI 探索了混合注意力架构、跑了 ablation;NaiveRT 这个推理运行时是 6 天、151 个有文档记录的优化 trial 做出来的——63 个被采纳,71 个验证失败或回滚,17 个探索性。AutoWM 的 case 最有说服力:研究员只定了目标、算力预算和评测协议(世界模型,不是这个实验室原来的方向),模型自己跑了 400 小时、15 轮大实验,中间甚至改了研究 setup 本身——重写 caption、把数据集从 2.5K 扩到 22.5K 个 clip、把帧选择重构成背包问题用动态规划解。最终 WorldArena-1 Track 1 拿到 77.43,超过之前公开最好的 73.64。这不是自动补全,这是一个实验闭环。
打折:每一步的方向、约束和验收标准都是人类定的,而最有信息量的是他们 kill 掉的那个点。一个 MoE kernel fusion 方案做了七轮实现——每一轮数值都正确——但每一轮 end-to-end 性能都倒退,于是人类研究员叫停了这个方向。AI 还提过一个短上下文 bypass:200 token 时省 3μs,2,200 token 时反而慢 3μs,被拒。他们自己总结的那句话是整篇发布里最好的一句:“A faster microbenchmark is not a faster model.”(microbenchmark 更快不等于模型更快。)AI 是一个配了顶级 instrumentation、干活极快的 junior engineer,在严格的人类 review 之下工作。这很了不起,但也不是 autonomous research。
值得行动的数字
价格:托管 API 按每百万 token 收 $0.10(输入)/ $0.40(输出)/ $0.01(cache 读)——对 1M 上下文的代码模型来说很激进,而且 MIT 协议意味着权重可以直接进企业部署。(自己部署需要支持 FP8 的 NVIDIA 卡,checkpoint 约 315GB。)
评测卫生,值得表扬:他们披露了自己分数的 harness(Claude Code 2.1.207、1M 上下文、temp 1.0/top-p 0.95、只有基础文件 I/O 和 Bash 工具),每个 benchmark 的竞品分数都逐项注明来源——厂商博客、model card、公开 leaderboard。AI R&D 那组分数来自他们自己的 in-house harness,他们直接写明了。厂商数字就该这么发:有来源、可复现、caveat 写清楚。
评测卫生,要求所有人做到:发布几小时内,聚合网站已经开始编数据了——有一家写 Apache 2.0 协议、$0.15/$0.60 定价、12T 训练 token,还列了 primary source 里根本不存在的 benchmark 分数。条条都和 model card 矛盾。凡是不是来自 naive.ai 或 Hugging Face model card 的数字,一律按 fiction 处理。
周一早上
- Throughput 卫生(下次跟厂商谈价格之前先做):任何 “tok/s” 宣称,先要三个数——单流还是多用户、纯 decode 还是含 prefill 的端到端、几张卡。拿不全,就按他们的 Standard/serving 数字做预算,不按 headline。这里就是 42 倍的 haircut(2,122 → 50)。
- 长上下文选型规则:任何 128K 以上上下文的工作负载,下次评测加一个无全注意力的候选。这次发布是在 309B/1M 规模上的存在性证明:没有稠密注意力,质量下限守得住——而稀疏注意力才是 KV-cache 经济账能算过来的关键。如果稀疏模型在你自己的任务评测上落在稠密 incumbent 的 2pp 以内,选便宜的。
- “AI 做研究”的审计方法,照他们的方法来:要 trial log。151 个 trial,63 采纳、71 回滚——以及谁 kill 了坏方向(人类,七轮之后)。任何自称 autonomous R&D 的实验室,拿不出 adoption/rollback 比例和人类干预次数,就是在卖新闻稿,不是在卖结果。
辩论
Naive-N0.5-Flash 解决了一个问题——1M 上下文里稠密注意力是可选的——同时把另一个问题问得更尖锐:如果一个稀疏注意力模型,$0.10/$0.40、MIT 权重,在代码和 agent 工作上 competitive,那些稠密注意力的 frontier 模型剩下的溢价到底在买什么?我的答案:买的是只有 frontier lab 才跑的评测,以及 indexer 选错那 2,048 个 token 的任务。你的呢?
所有数字均对照 primary source 核验:NaiveAI 技术博客 与 Naive-N0.5-Flash Hugging Face model card(2026-09-28 访问)。
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀