4B 开源模型打平 GPT-5.4:MetroLLM-Bench 与微调的「容量天花板」
Published:
一个 2.6GB 的开源权重模型,在一个真实的工具调用 benchmark 上追平了全开推理强度的 GPT-5.4。Frontier API 的溢价只买到了 0.05 个 Tier-1 分——而论文自己的 bootstrap 区间说这就是噪声。
结果来自 MetroLLM-Bench(Remco Hendriks,Continker,arXiv:2609.10016,2026 年 9 月 9 日提交):955 个 case,把语言模型放在地铁售票机的 policy 层——6 个真实地铁系统(MARTA、Doha、BART、台北捷运、CTA 芝加哥、北京地铁,37 到 414 个站点),11 个类别(路线、票价、突发中断、无障碍、政策、多轮、对抗输入、时间推理、工具幻觉、复合压力),6 个结构化工具,ReAct 循环上限 20 轮,最后必须提交一台售票机硬件能直接执行的 terminal state。评分分两层:Tier 1 是 14 个确定性组件(路线/票价正确性、工具调用准确率、渲染合法性),Tier 2 是 8 个语义质量组件(其中 6 个用 Claude Haiku 4.5 做 judge)。所有 headline 对比都用 Tier 1——完全确定性,judge 不在回路里。
部署结论
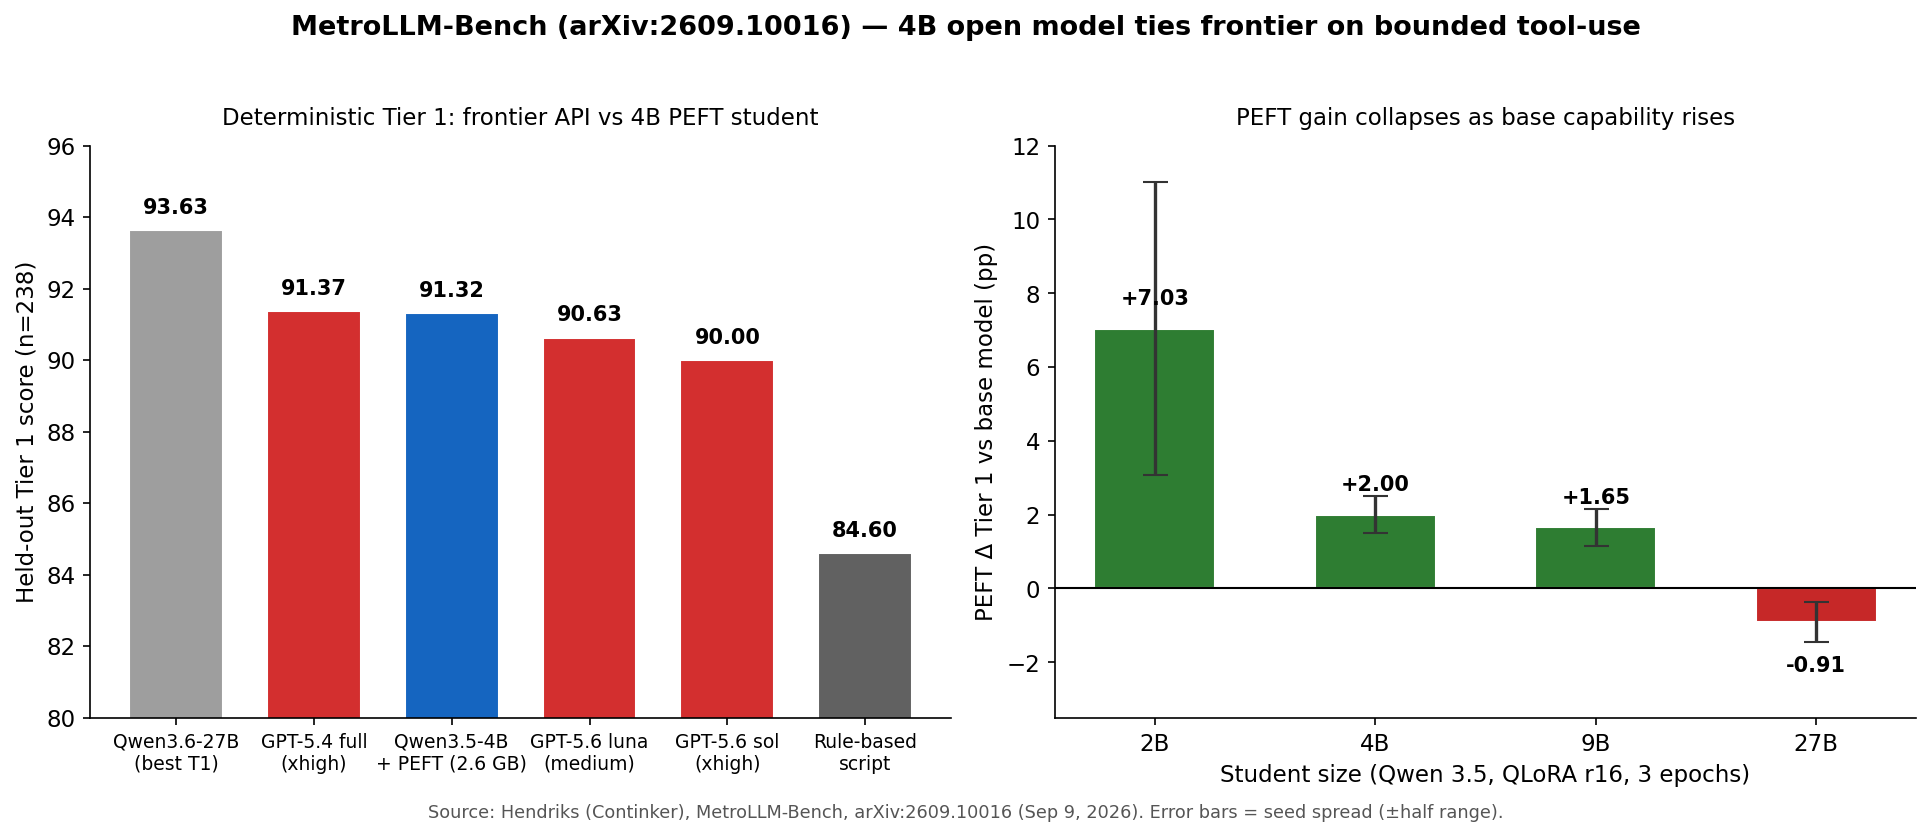
在 238 个 held-out case 上(训练前就固定好的 75/25 分层划分):
| 模型 | Tier 1 |
|---|---|
| Qwen3.6-27B(Tier 1 最高) | 93.63 |
| GPT-5.4 full(xhigh 推理强度) | 91.37 |
| Qwen3.5-4B + PEFT(2.6GB Q4_K_M) | 91.32 |
| GPT-5.6 luna(medium) | 90.63 |
| GPT-5.6 sol(xhigh) | 90.00 |
| 纯规则脚本 baseline | 84.60 |
4B 学生模型用 QLoRA(rank 16,3 个 epoch)训练,数据是 600 条 teacher trace——全部来自 717 个训练 case,要求 teacher(27B 或 35B)在 Tier 1 上 ≥90%(平均 99.0%)。总训练量:一张 RTX 5090 上 9.4 GPU 小时。相对 4B base 提升 +2.00,超过 GPT-5.6 两个 tier,距离全开推理的 GPT-5.4 只差 0.05。Held-out 上这个 0.05 的 bootstrap 区间是 [−1.80, +1.70];在全部 955 个 case 上两者打平(+0.01 [−0.93, +0.94])。作者原话:”frontier-level Tier 1 performance does not require a proprietary frontier API.”
另外两个值得知道的榜单事实:composite 第一是 Muse Glimmer 30B(Meta Superintelligence Labs,Apache 2.0),92.03——而且排名前六里只有两个 OpenAI 的位置是闭源的。前十一名挤在 3.18 个 composite 分里,基本就是单次运行的噪声地板,别过度解读具体名次。
容量天花板曲线
第 4 节是这篇论文真正的贡献:同一套 QLoRA recipe,分别训 2B、4B、9B、27B 四个学生模型,每个尺寸 2–3 个独立 seed:
| 学生模型 | Base Tier 1 | PEFT Tier 1 | 相对 base 的 Δ | Seed 波动 |
|---|---|---|---|---|
| 2B | 74.17 | 81.20 | +7.03 | ±3.97 |
| 4B | 89.32 | 91.32 | +2.00 | ±0.49 |
| 9B | 89.38 | 91.03 | +1.65 | ±0.50 |
| 27B | 92.32 | 91.41 | −0.91 | ±0.53 |
PEFT 收益单调衰减,到 27B 转负——而且每个尺寸上所有 seed 的方向都一致。在统计效力更高的全量矩阵上,4B 收益 +1.72 [+0.72, +2.74],27B 回退 −1.07 [−1.82, −0.38],两个区间都不包含 0。4B 以上实测质量是平的(91.32 / 91.03 / 91.41,极差 0.38),区分它们的只剩体积:2.6GB vs 16GB。
作者给出的解释我认同:base 越弱,adapter 能改变的行为空间越大,所以平均收益和 seed 间方差都随 base 逼近任务天花板而收缩。注意 2B 的 seed 彩票——三个 seed 之间 ±3.97,而 4B 以上只有 ±0.5。
Serving 配置陷阱
3.4 节是每个看榜单的人都该内化的警告。在统一 serving 配置下(greedy 解码,4096 token 上限),Qwen3.8-27B 相对 Qwen3.5-27B 看似退化了 3.60 个 Tier-1 分(89.48 vs 93.08)。拆开看:Qwen3.8 的推理 trace 长得多,4096 上限会在推理块里截断 case(把上限提到 16384 就拿回 +1.72);而且它的 model card 推荐 temperature 1.0 采样而非 greedy(再 +1.00)。按厂商推荐配置跑,两代差距只剩 0.07;按各自最优配置是 0.88。3.6 分的”退化”里大约 2.7 分是配置,不是能力。作者原话:”swapping the model name while keeping the serving configuration would have cost 2.7 points.”
那个没人先写的免费 baseline
一个确定性脚本 agent——固定工具调用顺序、读结构化字段、没有 LLM——Tier 1 拿到 84.6(composite 77.1)。路线(93.5)和票价(91.7)不错,到时间推理(52.1)、复合压力(68.9)、无障碍(69.7)、政策(73.3)直接断崖。凡是需要临场判断的类别,LLM 都带来 10pp 以上的提升。这个分界才是真正的工程 lesson:脚本告诉你 LLM 的钱花在了哪里。
坦率的 caveat
- Judge 单一来源。 Tier 2 八个组件里六个用 Claude Haiku 4.5。作者做了和两个人类标注者的校准(author–judge κw = 0.53,中等一致),并且——这是对的——没有任何 headline 结论单独基于 Tier 2。跨厂商 judge 校准列为未来工作。
- 27B 的 −0.91 可能部分来自硬件。 27B 学生模型 max sequence length 是 2048,其他尺寸是 4096(32GB 显存限制)。作者披露了这一点,也没验证去掉这个限制会不会翻转符号。但四个尺寸的单调衰减趋势不受影响。
- Held-out n=238 偏小。 所有单个 held-out 两两对比的 bootstrap 区间都包含 0;只有全量 955 case 矩阵(包含训练 case)达到显著。容量天花板的结论建立在”尺寸 × seed × 数据划分”的一致趋势上,不是某一次对比。
- 时间推理依然是 frontier 的地盘。 GPT-5.4 full xhigh 在 Temporal 上 composite 87.2,对 Qwen 27B base 73.5、GPT-5.6 sol 同强度 68.6(n=22)。”The advantage belongs to one frontier configuration rather than to reasoning effort as such.” 有界任务 ≠ 所有任务。
- 2B→4B 的 +15.15 是家族内结论,不是通用参数阈值;Qwen 35B-A3B(3B active 参数)composite 只排第七,跨家族解读要小心。
周一早上的 playbook
- 有界工具调用 agent?先蒸馏再租。 如果你的 agent 工具就几个、步数 ≤20、输出 schema 受限:花 ~2 周、一张消费级 GPU,用 ~600 条高质量 teacher trace(在你的确定性指标上 ≥90%)蒸一个 4B 开源模型。决策规则:如果 held-out 上和 frontier API 的差距落在 bootstrap 区间里——这里是 −0.05 [−1.80, +1.70]——那就是”统计上打平,发 2.6GB 的模型”。
- 先写确定性 baseline。 它零推理成本拿到 84.6。第一个 sprint 把确定性路径(你领域的”路线/票价”等价物)写成脚本;LLM 预算只花在论文实测出 >10pp 优势的类别:时间推理、复合场景、无障碍类 edge case、政策适配。如果你的任务全是确定性路径,你可能根本不需要 LLM。
- 换代必须重调 serving 配置,否则就是误读。 论文实测了 2.7 分的幻影”退化”来自 frozen config(输出上限截断 + 解码模式不对)。A/B 新一代模型之前,先按每个模型的推荐把输出上限和解码重调一遍,再读 delta。
- 按 base 能力给 PEFT 定预期。 2B 级弱 base 指望 ~+7pp(但至少训 3 个 seed——±3.97 的波动是彩票);4B 指望 ~+2pp;base 已经逼近任务天花板就别做 PEFT 了,把预算花在数据和 harness 上。
一句话 thesis:在有界的工具调用任务上,”直接调 frontier API”的条件反射现在是个预算错误——但 frontier 依然拥有那些靠判断而非流程的类别。
来源
- Hendriks, R. (Continker). “MetroLLM-Bench: Evaluating Language Models as Transit Kiosk Runtimes.” arXiv:2609.10016 [cs.LG],2026 年 9 月 9 日提交。https://arxiv.org/abs/2609.10016
- Benchmark、harness、复现指南、微调学生模型:https://github.com/continker/metrollm-bench
- 讨论热度:PAPERCUT 解读视频,2026 年 9 月 14 日(经社交媒体讨论发现)。
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀