什么时候该停止租 token?内部 RAG 的 build vs buy 临界点
Published:
每家公司接入 Anthropic 或 OpenAI 的剧本都一样:一个工程师一下午接好 API,demo 惊艳全场,半年后财务转发过来一份没人预算过的 token 账单。这就是 AWS 的故事重演——先为弹性付费租用,等规模上来了才发现,自己一直在租本该拥有的东西。
问题是,”规模”到底从哪里开始算?我把账算了一下。
三档选择,价格都是现价
以下价格均为 2026 年 9 月验证。混合单价按输入:输出 = 4:1 计算,这是 RAG 和 agent 类工作负载的典型比例——另外提醒一个老陷阱:输出 token 价格是输入的 5–8 倍,只比输入单价一定会选错模型。
| 档位 | 参考价格 | 混合单价($/M token) |
|---|---|---|
| Frontier API(Claude Sonnet 5:输入 $3 / 输出 $15) | Anthropic 定价 | $5.40 |
| Frontier API(OpenAI GPT-5:输入 $1.25 / 输出 $10) | pricepertoken.com | $3.00 |
| 托管开源 70B(Together AI Llama 3.3 70B:$1.04 / $1.04) | together.ai/pricing | $1.04 |
| 自建:32B 级模型跑在 1×H100(按需约 $2.70/小时) | RunPod/Lambda 定价 | 边际成本约 $0.50 |
顺带一提:OpenAI 从 8 月 21 日起把 GPT-5.6 Sol 降到 $4/$20,为期三个月(Reuters 经 quasa.io)。价格战是真的,但它只会移动临界点,不会消灭临界点。
临界点
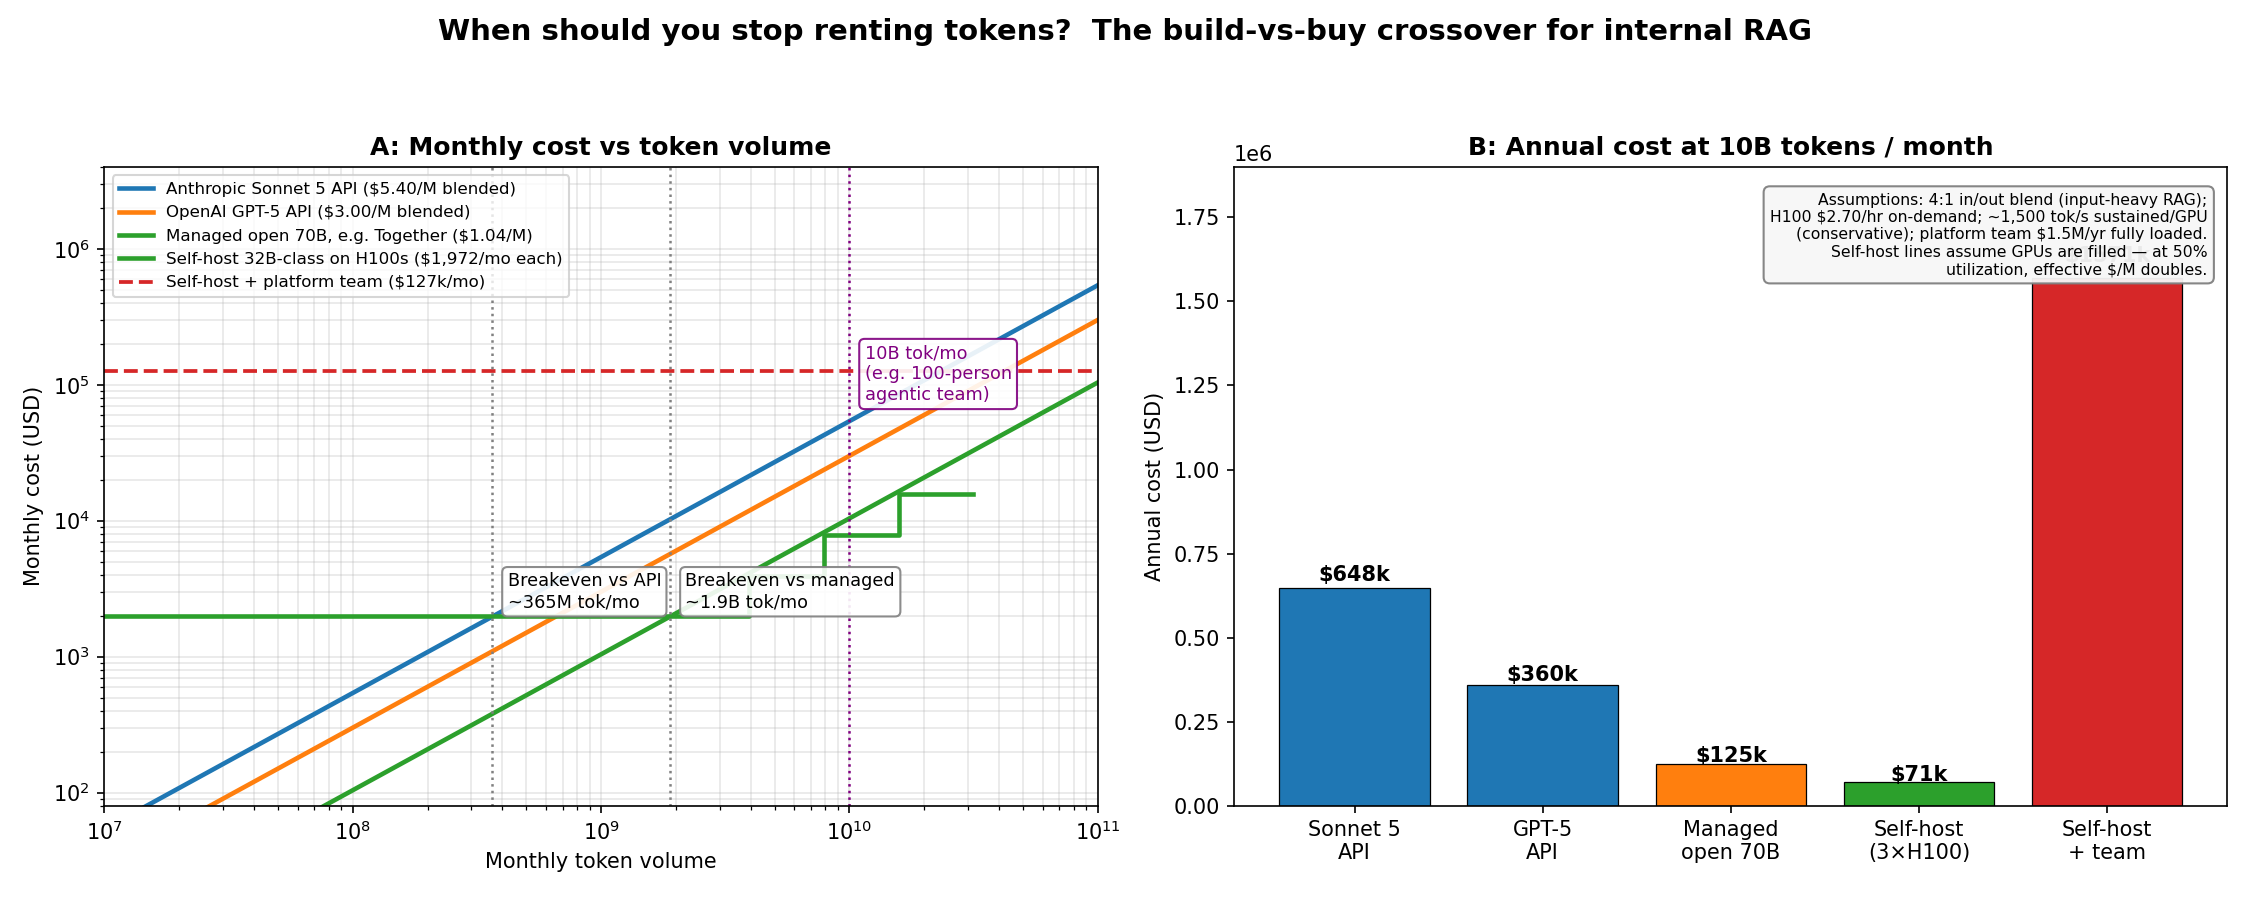
先把假设摆在台面上:一块 H100 按 $2.70/小时算,月成本 $1,972;在 32B 级模型上按每秒 1,500 token 的保守吞吐估算,单卡月处理约 39 亿 token。一个 2–3 人的平台团队,按 Staff 级别总包算约 $150 万/年。
- 纯硬件成本 vs frontier API:月 3.65 亿 token。 对应 API 花费约 $2,000/月。按每人每月 1 亿 token(上了 agent 之后很常见)算,4 个人就打平了;按每月 1000 万 token(重度聊天用户)算是 37 人。这个数字小得惊人,也是厂商希望你永远不去算的数字。
- 托管开源 vs 自建:月 19 亿 token。 托管档($1.04/M,零运维)已经吃掉了大部分差价,只有当你的卡真的被塞满时,自建才反超。
- 算上专职平台团队:vs API 是月 235 亿 token,vs 托管开源是月 1220 亿。 这才是真正要紧的临界点,比纯硬件版高出两个数量级。卡很便宜,人很贵。
右图在月 100 亿 token 的量级下更直观:年成本 $64.8 万(Sonnet 5)vs $36 万(GPT-5)vs $12.5 万(托管开源)vs $7.1 万(自建边际)vs $157 万(自建+团队)。人力税碾压一切。
周一早上做什么
- 算混合单价,别只看输入单价。 把上个月的输入/输出比例拉出来。如果你的负载输出占比高,还在拿 $3 和 $1.25 的输入价做比较,那算术一开始就是错的。
- 月 token 超过 3.5 亿,本周就去询托管开源档的价。 Together / Fireworks 一类的 70B 托管约 $1/M,比 frontier API 便宜 3–5 倍,零运维。对大多数公司来说,旅程到这里就该结束了。
- 只有”量够大 + 已有平台团队”才考虑自建。 月 20 亿 token 以上且团队现成,自建划算;专门为这事招一个团队,得月 200 亿以上的稳定量才算得过账。
- 不管选哪档,都把”成本公示”仪表盘建起来。 内部 token 免费时,没人做 effort routing、没人做缓存、没人去蒸馏小模型——成本不会消失,只会变成所有人平摊的容量争抢和排队延迟。每月公示”你们团队按 API 价烧了 $X”,不真收费,也能把节约的动力找回来。
诚实声明
- 质量等价是个假设,而且在高难度任务上不成立。 70B 开源模型在硬推理上不是 Sonnet 5——这正是 frontier 溢价买的东西。答案是路由:难任务走 frontier,大批量走便宜档。还是网关那一套。
- 自建曲线假设卡是满的。 利用率 50% 的话有效单价翻倍;内部工具早 9 晚 5 波峰、半夜闲置,API 的溢价本质上是弹性保险——这也是大多数公司永远不离开 AWS 的原因。
- 吞吐是最敏感的变量。 如果你的负载单卡能跑到 3,000 tok/s,所有自建临界点减半。拍板之前用自己的 serving 数据重算一遍。
- 合规和数据驻留 可能直接否决一切:受监管的数据不看你的临界点图表。
一句话 thesis:别再问”API 还是 GPU”——真正的 build vs buy 问题不在硬件而在人,而对大多数公司,答案是中间那档托管开源。
来源
- Anthropic Sonnet 5 定价($3/$15 每百万 token,2026 年 9 月 1 日起标准价):worthview.com
- OpenAI GPT-5 定价($1.25/$10 每百万 token):pricepertoken.com
- GPT-5.6 Sol 限时降价($4/$20 至 2026 年 11 月 21 日):quasa.io
- Together AI serverless 定价(Llama 3.3 70B $1.04/$1.04 每百万 token):together.ai/pricing
- H100 按需租用(RunPod/Lambda $2.59–$3.29/小时,2026 年 9 月):getdeploying.com
- 输出 token 成本陷阱与缓存乘数:dev.to field guide
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀