Holo4 与 $1.22 的桌面智能体:计算机使用能力正在从模型问题变成脚手架问题
Published:
9 月 28 日,巴黎的 H Company 发布了 Holo4——一个通用计算机使用模型系列:27B 稠密模型和 35B-A3B 混合专家模型。同一套权重,既能在屏幕上点按打字,又能自己写代码、跑代码,还能调 MCP 或 API 工具;在桌面、网页、安卓、代码沙箱和企业 API 上都是同一个模型、同一种调用方式。(来源:H Company 官方博客)
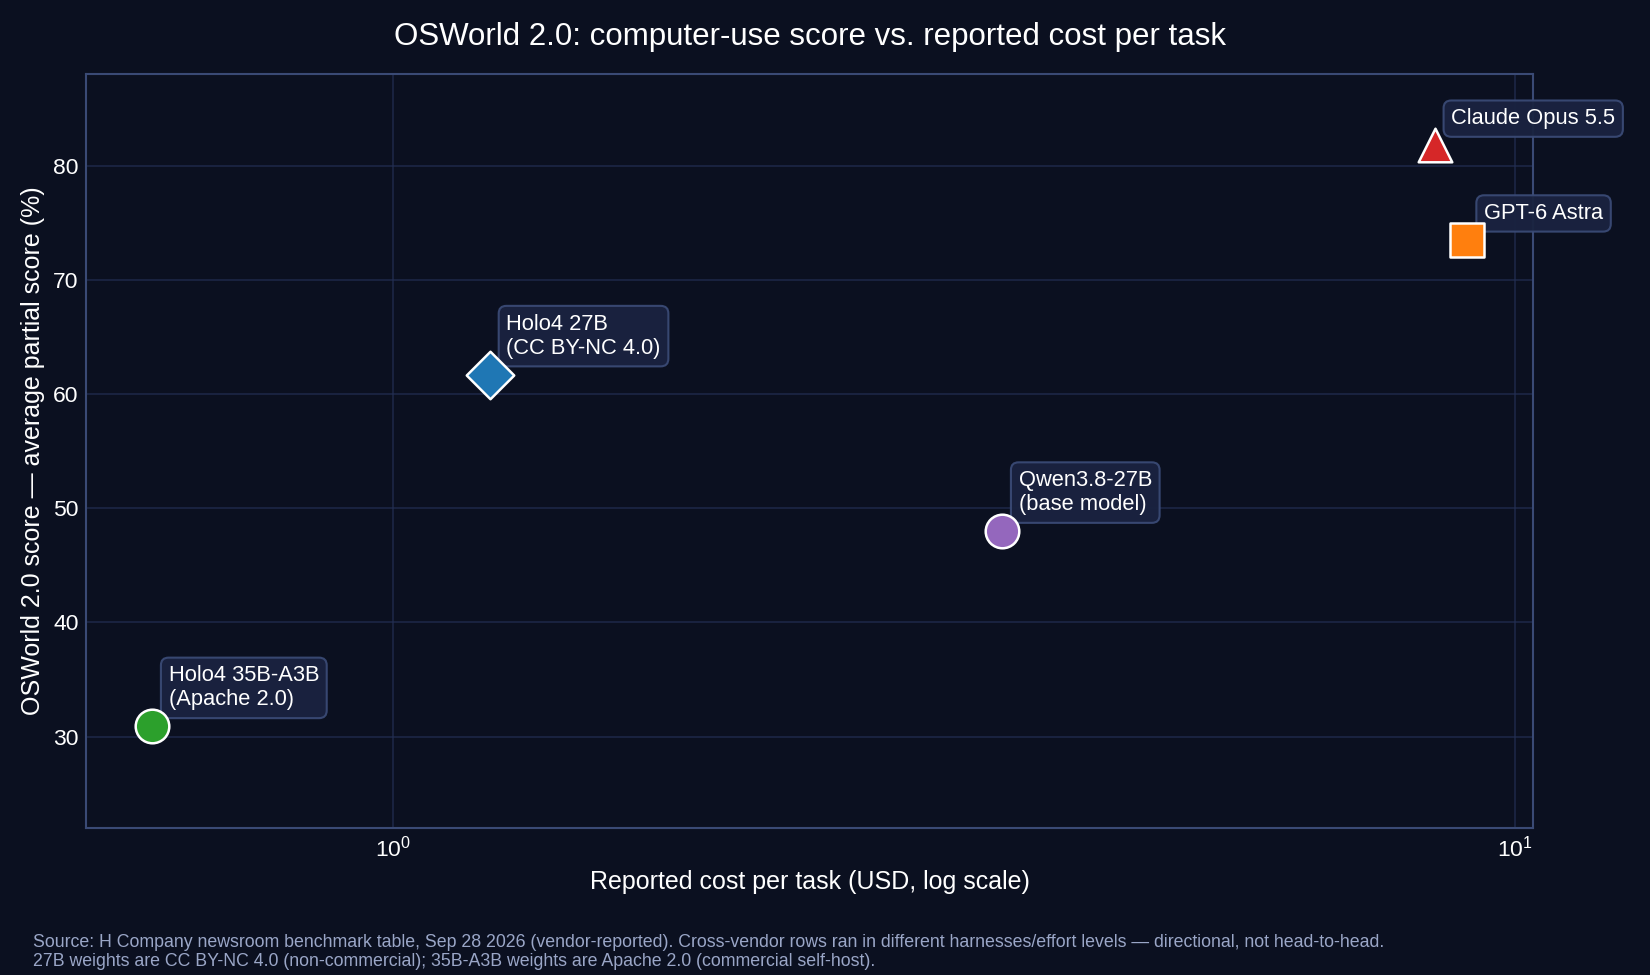
官方给出的 headline 数字对差距很诚实。长流程桌面基准 OSWorld 2.0 上,Holo4-27B 拿到 61.7%,Claude Opus 5.5 是 81.8%,35B-A3B MoE 是 30.9%。但单任务成本讲了另一半故事:H Company 官方表格里,Holo4-27B 每个任务 $1.22,Opus 5.5 $8.48,GPT-6 Astra(73.5%)$9.07。用大约 1/7 的价格拿到了前沿模型 75% 的分数——而这是一个能塞进单张高端 GPU 的 27B 模型。
让人意外的是配方,不是模型
Holo4-27B 是从 Qwen3.8-27B 微调出来的——这个基座在官方表格里 OSWorld 2.0 只有 48.0%。+13.7 个点的提升来自后训练基础设施,而不是更大的基座:
- Agentic Task Factory:内部流水线,只凭文档就能生成可验证的交互式任务——目前约 1 万个(4k 网页应用、3k MCP 服务器、3k 桌面/OS),还包括 GUI 和 MCP 双通道暴露同一状态的混合环境。一个任务要能留下,必须通过”拒绝近似答案”的验证器。
- 127B token 的 SFT,其中约四分之三是成功的智能体轨迹,覆盖桌面、网页、MCP/API 和移动端。
- 两个 RL 专家,一次合并:异步在线 RL 训练两个 LoRA 专家(一个管桌面+网页,一个管终端+MCP+API),等权重合并,不再额外训练。
- 重造的 harness:H 用 OSWorld 2.0 的失败分析重做了智能体循环。两个最大的改动:能记住几百步的可靠记忆,和桌面机器上真正的 shell。
而且这套配方是可迁移的。H 把同样的后训练流程套到 NVIDIA 的 Nemotron 3 Nano Omni 上(Holotron4 Nano):OSWorld 从 21.0% 拉到 76.3%(+55.3 个点),AutomationBench 从 19.4% 拉到 35.6%(+16.2 个点)。官方原话:”nothing in it is size-specific”(没有任何环节是尺寸相关的)。这是整个发布里最有力的证据:壁垒在工厂和 harness,不在权重。
效率也体现在 token 账上。在”用 Godot 做一个吃豆人游戏”的任务里,Holo4-27B 用了 68 次调用、2.4M token,而基座模型用了 197 次调用、11.4M token——省了约 5 倍 token。token 节俭是绝大多数选型测试从不衡量的成本维度。
许可证断崖
真正改变部署算账的是这里。两个版本的许可证不一样:
- Holo4-27B:CC BY-NC 4.0——非商用。商用只能走 H 的 API(输入 $0.40 / 输出 $3.00 每百万 token)。
- Holo4-35B-A3B:Apache 2.0——完全商用自部署(API 价 $0.30/$2.00 每百万 token)。
能商用自部署的那个版本只有 30.9%——是 27B 的一半。先按分数排名、后查许可证,你会选中一个根本上不了线的模型。
该夸的夸,该挑的挑
H 把公开分数背后的每条轨迹都开源了(trajectories.hcompany.ai + Hugging Face 数据集),可以一步步回放。这是应该拿来要求所有厂商的审计标准。
但读这张图时也要按 H 自己交代的方式读:
- 跨厂商的行跑在不同的 harness、不同的 effort 下(Opus 5.5 是 Anthropic harness 的 max effort;GPT-6 Astra 是 82 个任务的离线子集)。只能当方向性参考,不是正面交锋。
- 61.7% 是平均 partial score,任务成功率是 41.5%。partial credit 天生偏爱多步智能体——看厂商引用哪个数字,心里要有数。
- AutomationBench 公开集 600 个任务里有 480 个落在 H 采集训练数据的 split 里。在剩下的 120 个 held-out 任务上,Holo4-27B 是 49.3%。private set 结果还没出。
- 单任务成本是按各 run 自己的输入/输出 token、按厂商自家 API 价估的。
周一早上可以做的三件事
- Replay,别 re-benchmark。 拿 30–50 个你自己真实的桌面任务,用 H 开源的 hai-agents harness 同时跑 Holo4-27B(API 或非商用权重做内部评测)和你现在的前沿方案。只有当你自己的任务上完成率差距超过你的误差预算(比如 >10 个点),才付前沿模型的单任务价格。官方那 20 个点的差距是厂商自己测的、跟 harness 强相关。
- 许可证先行,分数后排。 在你的模型准入 checklist 里,把”商用自部署许可”这一列放在基准分数前面。这次能商用的版本分数只有一半——试点做完才发现,浪费的是一个季度。
- 按完成任务计价,不按 token 计价。 给每个智能体选型都加一列”每完成一个任务消耗的 token”。Holo4 在游戏任务上 5 倍的 token 节省,在按百万 token 计价的表里永远看不见。
所以:OSWorld 2.0 最后那 20 个点,值不值 7 倍的单任务成本——还是 harness 在做真正的功?一套能把 nano 基座拉起 55 个点的配方,答案已经偏向后者。从现在起,重要的基准不再是排行榜,而是一个许可证+成本+harness 的三元组,在你自己的任务上测。
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀