特斯拉承诺 80 倍算力芯片——2029 年见,改名才是真新闻
Published:
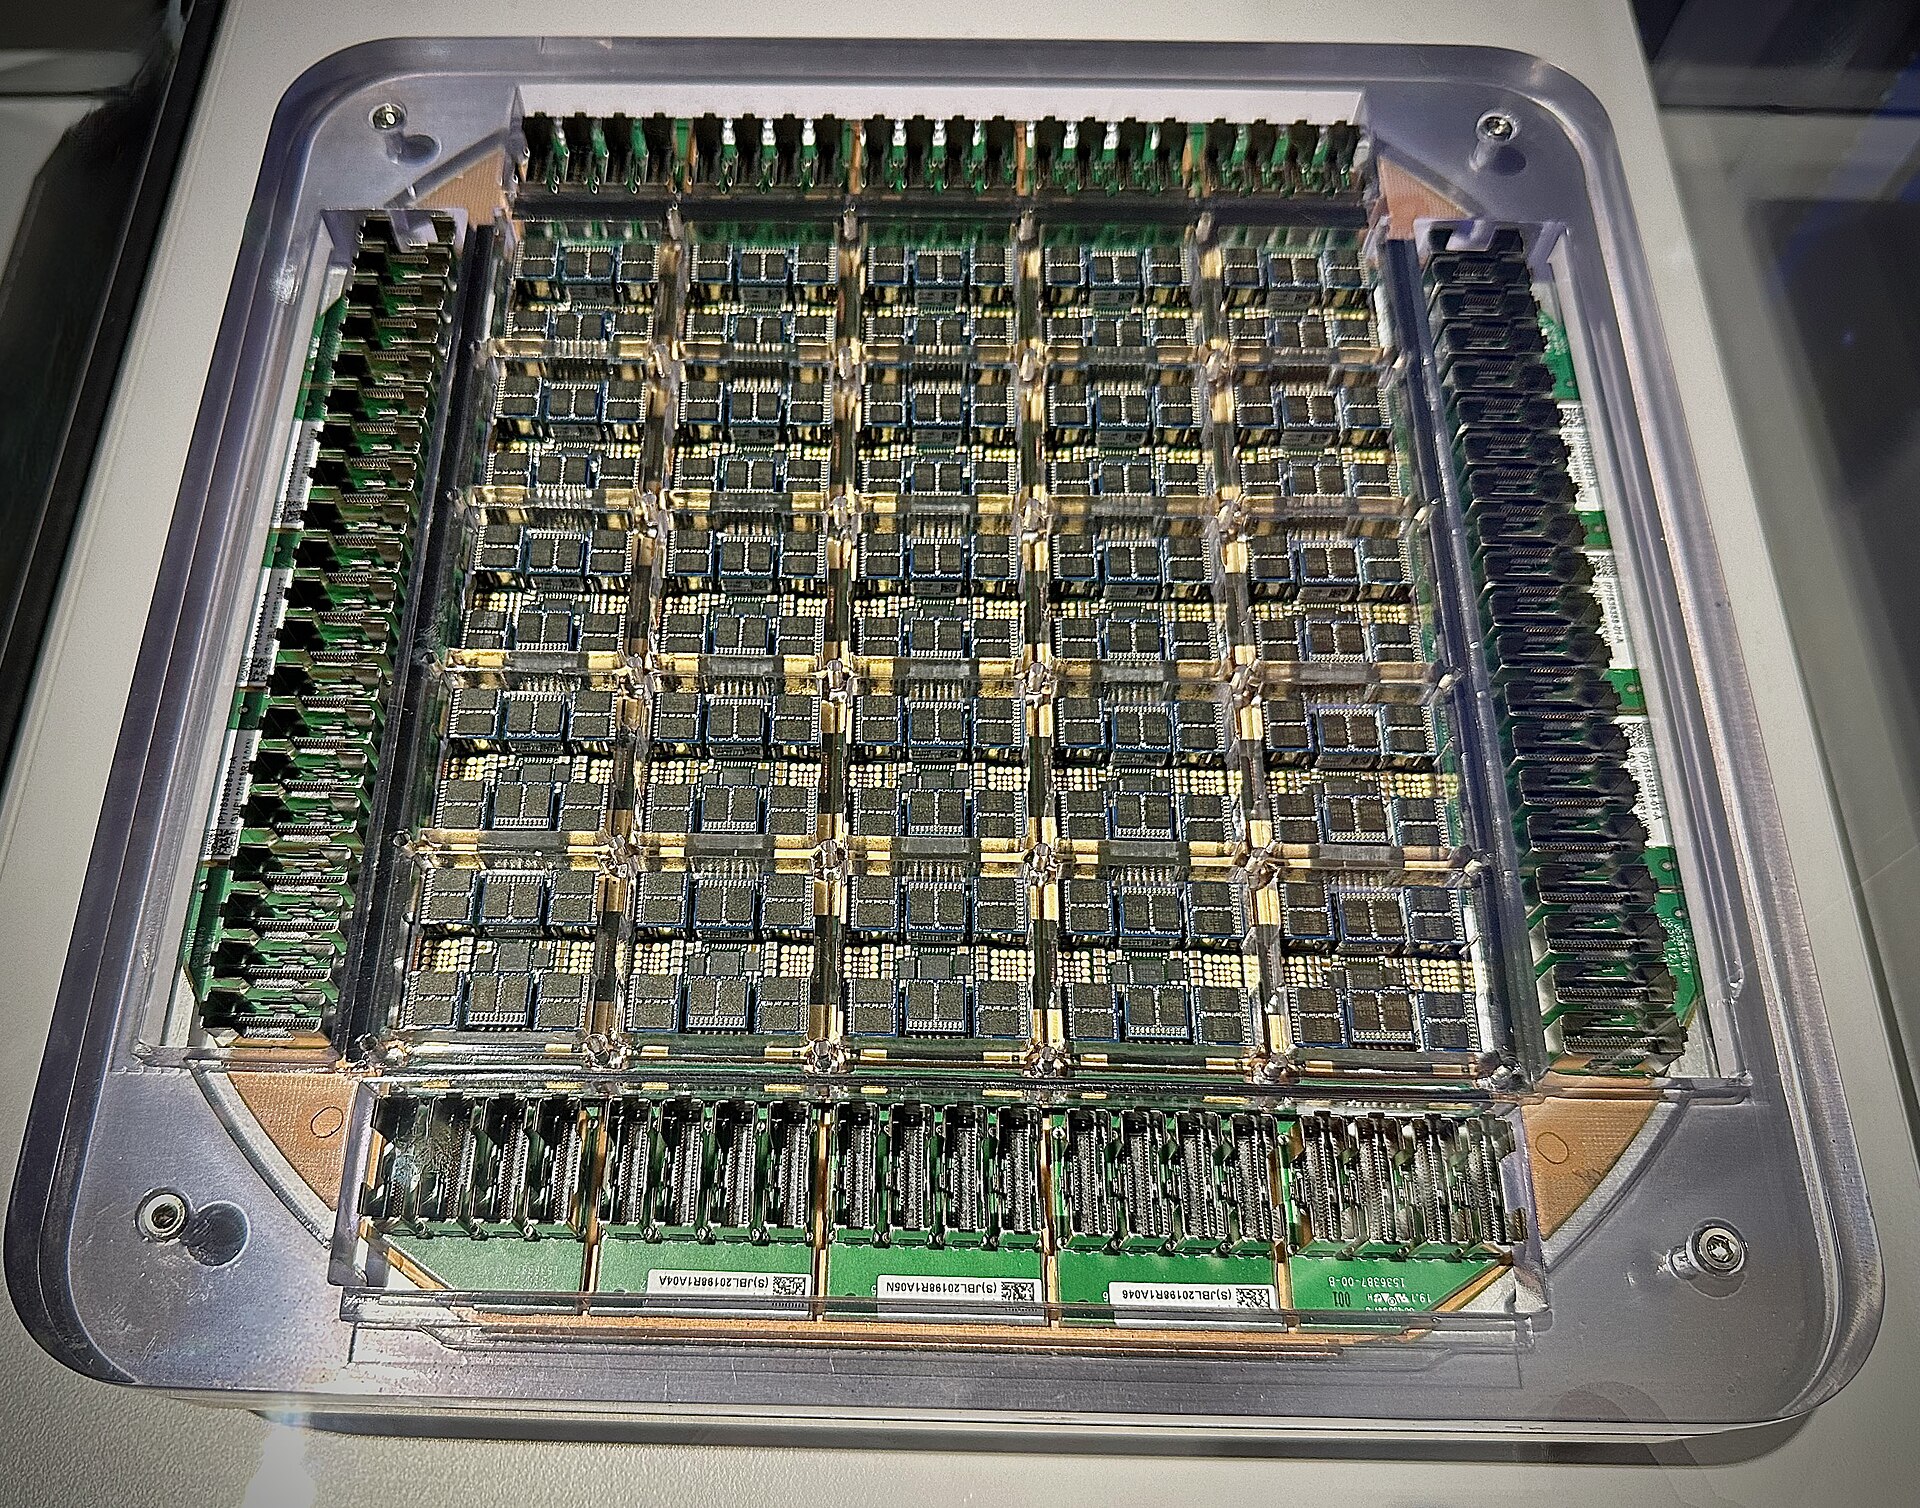
特斯拉 Dojo 超级计算机晶圆片——单块晶圆级芯片上集成 25 颗 D1 芯片。Dojo 3 放弃的正是这个设计。图片:Wikimedia Commons。
特斯拉公布了什么
特斯拉发布了修订版的 AI 加速器路线图,而最显眼的变化根本不是技术:芯片不再叫 AI4、AI5、AI6,改叫 SI4、SI5、SI6——”SI”即”Super Intelligence(超级智能)”,这是特朗普总统力推用来替代”人工智能”的说法。马斯克已确认 SpaceX 的 AI 部门也做同样的改名,变成 SpaceXSI。
标题数字属于第六代。特斯拉称,SI6 推理芯片的算力将达到现有第四代芯片 SI4 的 80 倍,内存为 9 倍。按 SI4 估算的 216 至 576 TOPS 基线折算,大约是 17,280 至 46,080 TOPS——即 17 至 46 POPS,内存约 144GB,由三星代工以 2 纳米级工艺制造。芯片预计 2029–2030 年推出,特斯拉已与三星签约,由其代工至 2033 年。
星号条款
这些数字要仔细读,因为特斯拉自己也邀请你这么读。80 倍这个倍数来自特斯拉的演示材料,绝对数值是基于估算的 SI4 基线推导出的估算值,而特斯拉没有披露 SI6 支持哪些数据格式——数据格式决定了 TOPS 数字在实际中有没有意义。特斯拉根本不正式披露这些芯片的绝对算力、内存容量或功耗。
所以诚实的表述是:特斯拉公布的是一个方向,不是一个产品。验证点在 2029 年左右,从现在到那时的一切,都是一颗尚不存在的芯片的宣称。
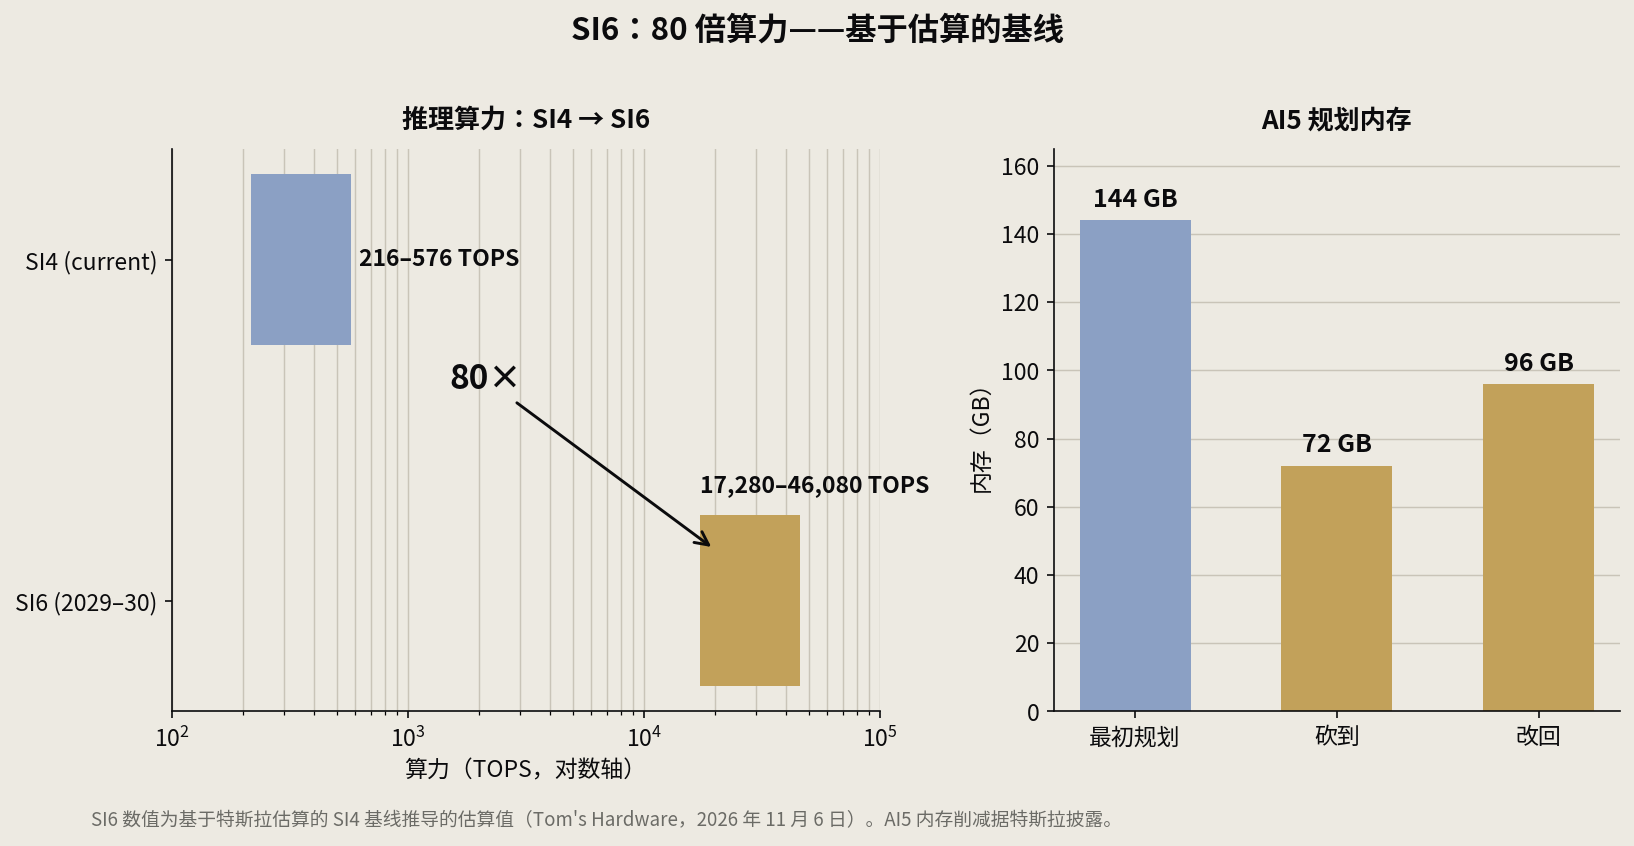
左:SI6 的 80 倍算力目标,对照估算的 SI4 基线(对数轴)。右:AI5 规划内存,一个月内被砍两次。图表:本站据特斯拉路线图材料(Tom’s Hardware 报道)制作。
Dojo 3 改主意了
路线图里更有意思的部分,是特斯拉自研训练加速器 Dojo 的回归——而它回来时已是一台不同的机器。第三代 D3 放弃了定义前两代产品的晶圆级集成与分布式片上 SRAM 架构,转而采用 chiplet(小芯片)设计,配合 2.5D 与 3D 封装及堆叠式 HBM 内存。
这是一次真正的掉头。晶圆级集成曾是 Dojo 的身份标识——赌的是一整块晶圆的算力胜过许多小芯片连在一起。D3 承认了业界几年前就已定论的观点:小芯片加堆叠内存赢了。特斯拉没有披露 D3 的算力、内存、工艺或时间表,所以这次让步的规模仍不清楚。但方向毫不含糊,而且与 Dojo 最初的卖点正好相反。
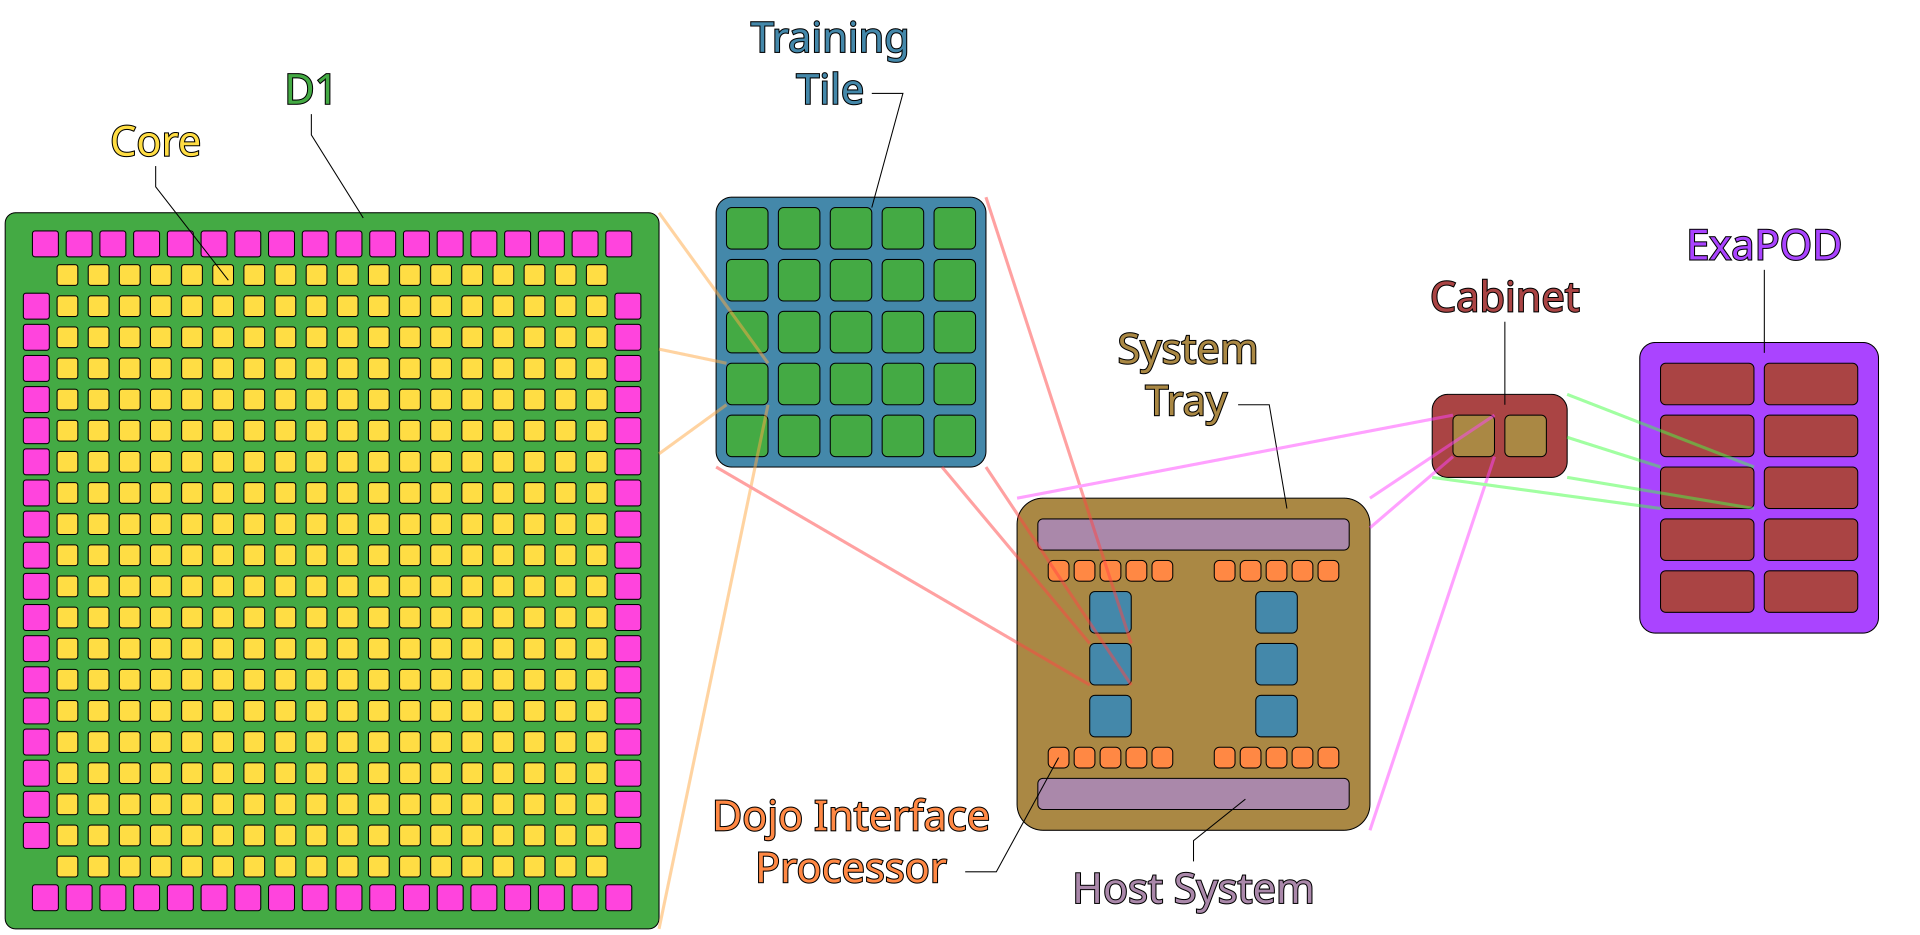
Dojo 原始架构,从单颗 D1 芯片到 ExaPOD——晶圆级集成与分布式片上 SRAM。D3 把这两点都放弃了。图示:Wikimedia Commons。
内存的讽刺
特斯拉自己的路线图里有一个它没有主动提及的张力。就在上个月,马斯克把 AI5 芯片的规划内存从 144GB 砍到 72GB,又改成 96GB,目的是为 Optimus 量产争取足够的芯片供应——这是一场与挤压整个行业的内存短缺进行的公开实时谈判。AI5 正在三星得州 Taylor 工厂试产,目标 2027 年扩大生产,2027 年 4 月左右集成进 Optimus。
换句话说:特斯拉真正能按期交付的下一颗芯片,是那颗内存刚被砍过两次的芯片;而内存翻 9 倍的那颗,要等到 2029–2030 年。路线图不花钱,内存供应才花钱。
判断
SI6 的发布最好拆成三个故事来读。改名是政治,而且已经完成——”超级智能”如今是马斯克旗下公司的统一风格。Dojo 3 的转向是工程,而且是路线图里最诚实的部分:特斯拉承认自己的标志性架构输了。80 倍是营销,在有真实芯片可测之前,它都只是营销。
这些并不意味着路线图毫无意义。一家自己设计训练与推理芯片、与三星签约代工至 2033 年的车企,是在做一场严肃的垂直整合赌注——这场赌注支撑着 Robotaxi 与 Optimus 两个项目。但要记住的数字不是 80,而是 2029。在那之前,特斯拉的芯片故事是一个承诺,而它要面对的内存市场,刚刚逼它把下一颗芯片砍掉了一半。
本文路线图数字来自特斯拉演示材料,据 Tom’s Hardware 2026 年 11 月 6 日报道;绝对算力数值为基于 SI4 基线推导的估算值,原始报道中已有说明。
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀