
开源权重差距一夜之间翻了四倍:模型没变,变的是考卷
Published:
2026 年 10 月 27 日,Artificial Analysis 发布了智能指数 v5,这是自 1 月 v4 上线以来最大的一次改版。正在四处传播的头条数字是开源权重的差距:从 v4.3 的 3 分拉大到 v5 的 12 分。粗看之下,像是开源模型在一个季度里被甩开了。但只要读一遍方法论,就是另一个故事:所有模型脚下的考卷,在同一时间被换掉了。
到底改了什么
v5 有三处结构性变化:
- 指数 60% 的分数现在来自私有测试集或不公开答案的评测——这是该指数历史上第一次让多数分数落在可检验边界之外。这是有意为之的反污染动作,就这个目标而言方向是对的:公开测试集会漏进训练数据,这是全行业心知肚明的事。
- 新增两个基准、升级三个。 FrontierCode 2.0(Cognition 的私有基准,132 个真实编码任务,按维护者是否愿意合并改动来评分)和 Terminal-Bench-Science(70 个在终端里执行的智能体科研任务)进入指数。Humanity’s Last Exam 被精修过的 1000 题版 HLE-Diamond 取代;AA-Omniscience 升级到 v1.1,删掉了已饱和和已公开的题目;CritPt v2 改用一个私有的 40 题高难子集评分。
- 任务的工作量大幅上升。 每个指数任务的输出 token 中位数涨了三分之二,从 v4.3 的 35K 涨到 v5 的 59K。智能体类评测占指数权重 55%,却吃掉了约 90% 的输出 token,其中 Terminal-Bench-Science 一项就占约三分之一。
与 v5 同时发布的还有进度指数 Progress Index v1,用一条连续刻度追踪能力随时间的变化——这等于默认承认:头条指数本身已经不再支持干净的跨版本对比。
经核实的结果
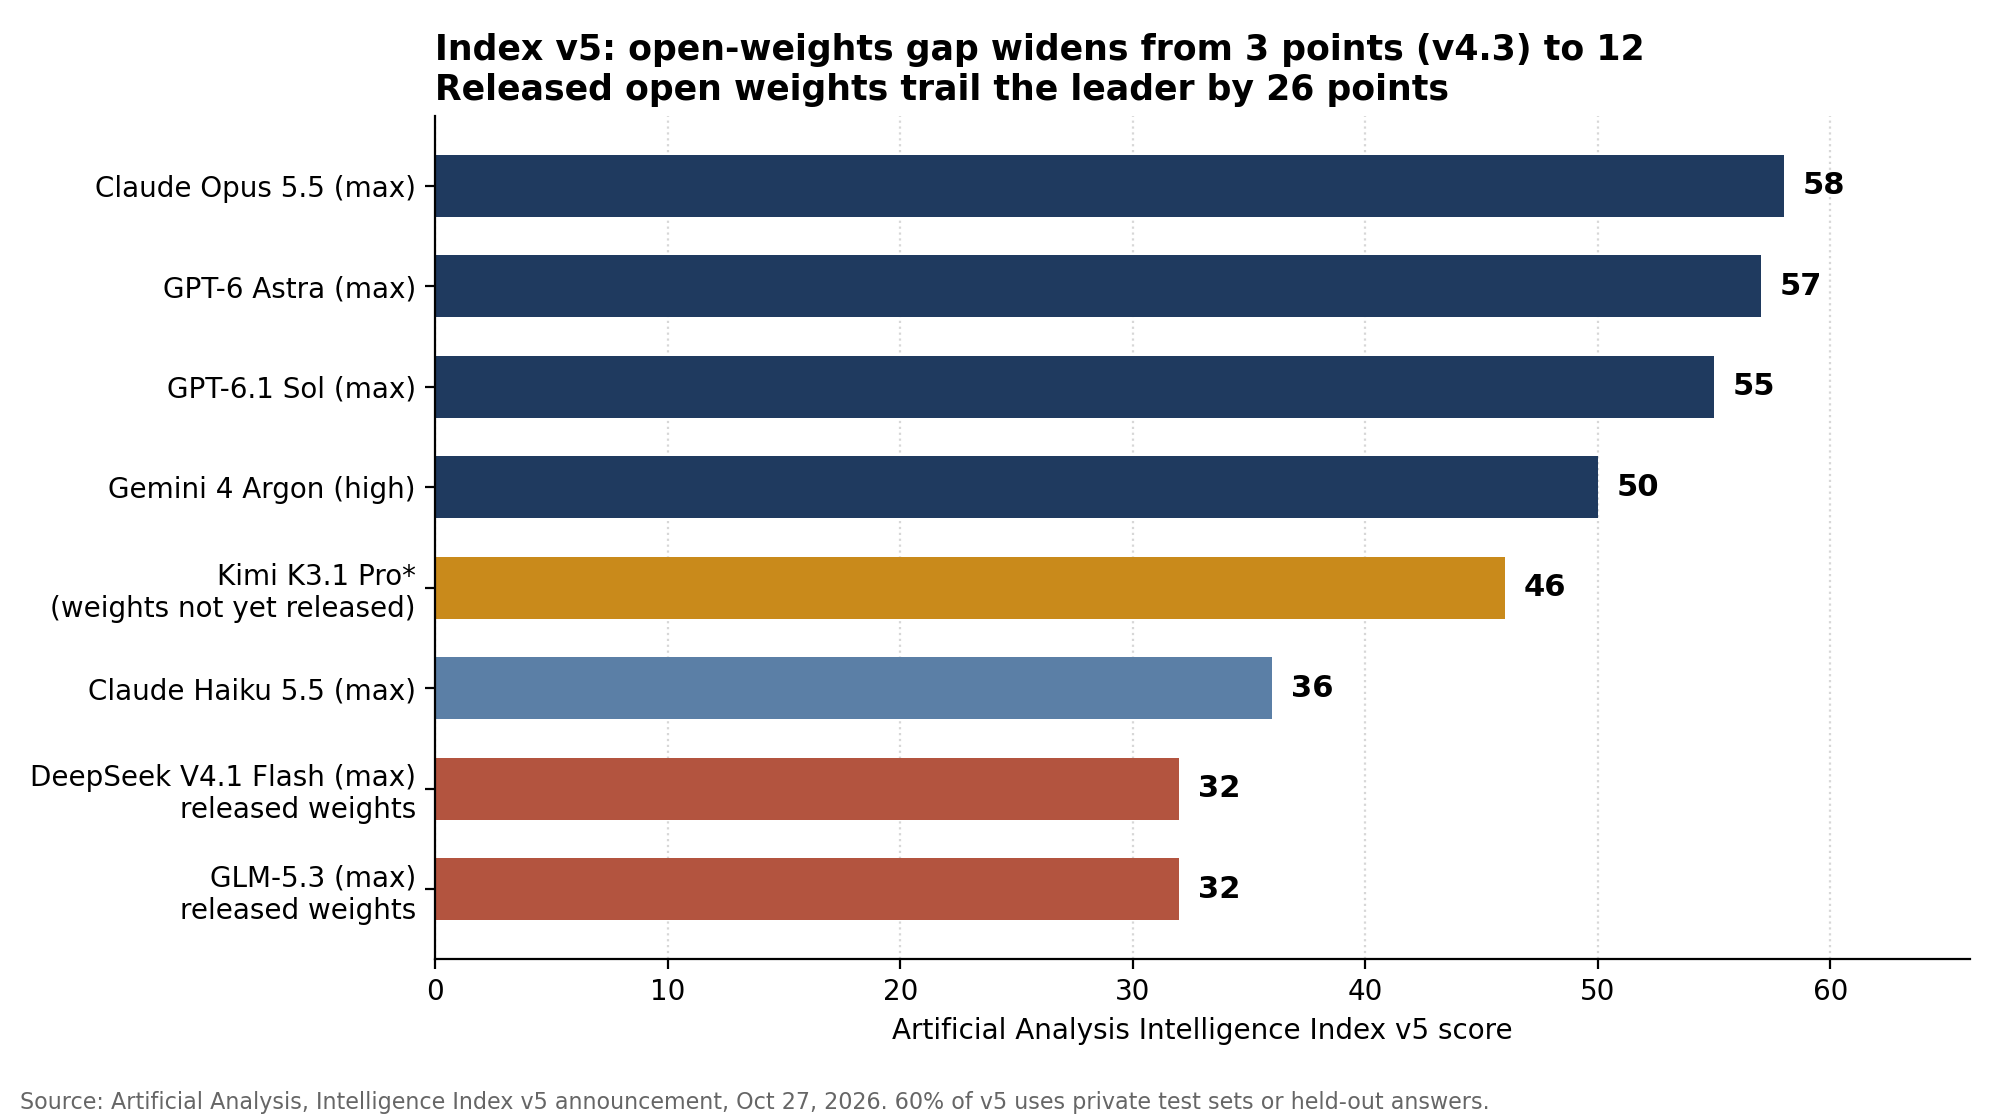
- Claude Opus 5.5(max)以 58 分居首,其后是 GPT-6 Astra(max,57)和 GPT-6.1 Sol(max,55)。Gemini 4 Argon(high)以 50 分紧随其后。Anthropic 与 OpenAI 包揽前五,且没有任何一个模型在全部九项评测中都领先。
- 排名最高的开源权重模型是 Kimi K3.1 Pro,46 分——但关键限定是:它的权重尚未发布。
- 在真正已发布权重的模型里,DeepSeek V4.1 Flash 1017(max)与 GLM-5.3(max)以 32 分领先——落后榜首 26 分,甚至低于 Claude Haiku 5.5(max,36)。
- 差距是集中的,不是均匀的。HLE-Diamond 上,Kimi 得 37%,Opus 5.5 得 68%。Terminal-Bench-Science 上,Astra 以 63% 领先,Kimi 得 34%,最好的已发布开源模型(DeepSeek V4.1 Flash)只有 13%,多数开源模型低于 10%。
- 还有一个反向信号:Kimi K3.1 Pro 在 Terminal-Bench 4.0 上以 67% 独占第一,领先所有闭源模型。FrontierCode 2.0 上,Opus 5.5 以 46% 领先,DeepSeek V4.1 Flash 以 28% 是最高的开源模型。
成本数字比综合排名更重要
这份发布里对决策最有价值的一行不是排名,而是每个任务的成本:Claude Opus 5.5(max)每个指数任务 $10.04,GPT-6 Astra(max)$6.24,GPT-6.1 Sol(max)只要 $1.27。Sol 以约八分之一的单任务成本,拿到了与榜首只差几分的分数(55 对 58)。在展示的十个最高分模型里,单任务成本相差 13 倍以上,从 GPT-6.1 Terra 的 $0.96 到 Claude Fable 5.1 的 $13.04。
努力程度(effort)设置把同一件事说得更清楚:Opus 5.5 在低 effort 下得 35 分、max 下得 58 分,单任务成本也随之涨 10 倍($0.98 对 $10.04)。所以一个 v5 分数不是某个模型的属性,而是模型、effort 设置、评测框架(Artificial Analysis 在 FrontierCode 上用自家的 Stirrup 框架、每题跑三次)和一套大体私有的考卷,四者共同的属性。
那么,拉大的差距到底证明了什么?
证明了两件事,而这两件事不能混为一谈:
- 在长时、私有、智能体类任务上,前沿实验室的优势是真实且巨大的。 Terminal-Bench-Science 上最好的已发布开源模型只有 13%,榜首是 63%——这不是舍入误差。如果你的工作负载就是带隐藏评分的多小时终端科研任务,已发布开源权重目前还替代不了,不管旧综合分怎么说。
- 3 分变 12 分的头条,主要是测量方式变了,不是模型退步了。 同一个「被甩开」12 分的 Kimi,同时在一个沿用的基准(Terminal-Bench 4.0)上独占第一。模型在 v4.3 到 v5 之间没有变差;变的是尺子——新尺子偏向私有数据和长时智能体运行,而这恰好是闭源实验室有结构性优势的两个维度(私有评测基础设施,以及在 max effort 下每题烧掉中位数 59K token 的推理预算)。
还有一笔治理成本要点名:当一个综合分数的 60% 建立在私有测试集或不公开答案之上,外部团队就无法独立复现这个排名。这也许是反污染的正确取舍——我认为大体上是——但它改变了这个指数的性质:与其说它是公开基准,不如说它是一家评级机构,它的方法你只能选择信或不信。
周一可以做什么
- 不要再用综合分给开源与闭源重新排名。 只看与你的工作负载对应的那一个指数分类(知识工作、编码、科学、通用)。只有当你的那个分类里的差距超过 10 分时,才考虑放弃某个开源模型——综合差距完全可以由你根本不跑的分类制造出来。
- 给 effort 设置定价,而不是给模型名字定价。 同一个模型的 effort 旋钮里藏着 23 分的摆幅(单任务 $0.98 到 $10.04)。付 max effort 的价钱之前,先在自己的任务上验证:一个中档模型开 max,是否打得过你现在用的前沿模型开低 effort——按 v5 自己的数字,这种交易经常存在。
- 给私有基准的分数打一个可复现性折扣。 如果 60% 的分数没法检验,那么在任何自研与采购决策里,就相应调高其余公开、可复现评测——以及你自己的留出任务集——的权重。
开源权重的故事本周并没有逆转。逆转的是测量方式——而分清这两件事,比那 12 分本身更值钱。
来源:Artificial Analysis《Announcing Artificial Analysis Intelligence Index v5》(2026 年 10 月 27 日)——以上所有分数、成本、token 数据与方法论细节均出自该公告。
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀