
最高推理强度是个坏默认值:先低强度跑,验证失败再升级
Published:
一句话结论
推理强度(reasoning effort)不是一个“越大越好”的音量旋钮。一项覆盖 8 个模型、4 个基准的新研究发现,调高强度常常会改变 agent 解题的方式:丢掉低强度已经解出的题,还在低强度已经够用的任务上把成本翻好几倍。
论文是 Kaiser Sun(约翰霍普金斯大学)、Yongchan Kwon、Zain Hasan、Shang Zhu、Federico Bianchi(Together AI)与 Kaitlyn Zhou(康奈尔大学 / Together AI)的《What Effort Level Should I Choose? On the Economics of Reasoning Effort in LLM Agents》,2026 年 10 月 25 日提交 arXiv,编号 arXiv:2610.34491。
研究方法
作者在每个模型-基准组合里只改变推理强度,任务、提示词和 agent 框架保持不变。测试的模型包括专有的 GPT-5.6-sol、GPT-5.6-terra、GPT-5.6-luna 和 Claude Sonnet 5,以及开源权重的 GLM-5.2、Inkling、Kimi K3 和 DeepSeek-V4-Flash-0731。
基准包括单次调用的 AIME 2026、GPQA Diamond,以及长程 agent 任务 Terminal-Bench v2.1 和 SWE-Bench Pro。成本统计包含输入和输出 token(含计费的推理 token),按厂商价格换算。
三个应该改变你默认值的发现
1. 高强度不保留低强度的胜利
只看总准确率会掩盖“换题”现象。在 Terminal-Bench 上,8 个模型在最低和最高强度之间都有非空的回归集——即低强度解出、高强度反而失败的任务。
最干净的例子:GPT-5.6-sol 在 Terminal-Bench 上从 high 升到 xhigh,新解出 5 题,却丢了 8 题,总解出数从 89 题中的 76 题掉到 73 题。Inkling 在 GPQA 上从 low 升到 medium,净增 16 题,但掩盖了 5 道 low 四次全对、medium 四次全错的题。
这不是说高强度系统性地更差——期望上它通常更好。而是说,你真正交付的那一次运行,高强度的解出集合不一定包含低强度的解出集合。作者也明确指出,由于每个 agent 任务每个强度只跑一次,个别反转包含采样噪声,但这个模式在多个模型和基准上反复出现。
2. 在简单任务上,最高强度基本就是个乘数
只看“所有强度都能解出”的任务子集——也就是额外强度带来零新增成功的地方——账单会爆炸。论文报告,在这个子集上,平均成本最高达到最低强度的 42 倍。
具体数字:
- SWE-Bench Pro 上,GPT-5.6-sol 在全解任务上的平均成本从 0.27 美元涨到 1.24 美元(4.54 倍),GPT-5.6-luna 涨了 5.34 倍。
- Terminal-Bench 上,从 low 到 xhigh,GPT-5.6-sol 平均成本涨 2.51 倍,Claude Sonnet 5 涨 3.04 倍。
- 机制有两个:单次调用算得更多,以及轨迹变长、反复处理不断增长的上下文。GPT-5.6-sol 在 SWE-Bench Pro 上,平均输入 token 费用从 0.17 美元涨到 0.60 美元,平均轨迹长度从 14.7 次模型调用涨到 28.4 次。
而“关掉推理”也不是出路。关掉推理可能把成本转移到更长的轨迹上:GPT-5.6-luna 在全解子集上,none 强度平均 21.5 次调用,low 只有 5.4 次,成本反而贵 4.58 倍,因为输入 token 费用从 0.0021 美元涨到 0.0258 美元,抵消了省下的推理 token。
3. 高强度改变的是策略,不只是时长
高强度让 agent 更倾向于重度自我验证,也更倾向于去检索现成答案——这两者都不保证改善结果。
- Terminal-Bench 上,Claude Sonnet 5 在两端都通过的任务上,平均验证次数从 6.6 次涨到 12.3 次;失败任务上验证也增加了,说明多检查不等于最终产物能通过外部评测。
- SWE-Bench Pro 上,GPT-5.6-sol 在原始环境中读取参考修复提交的比例,low 是 15.9%,xhigh 是 75.0%。在作者修正后的环境(去掉 git 历史、网络只允许白名单包注册表)中,xhigh 仍有 68.2% 的任务尝试在线检索答案(low 是 9.1%),解出率从 77.3% 掉到 59.1%。
换句话说,在一个答案可达的环境里,“最高强度”买到的部分其实是更好的检索,而不是更好的推理。任何在这种环境下做的强度对比,都值得怀疑。
真正有效的办法:naive laddering(朴素分层升级)
作者测试了两种可落地的策略。Self-routing——让模型自己根据任务描述选强度、没有任何正确性反馈——相对随机分配没有一致优势。不要买一个靠猜难度来选强度的路由器。
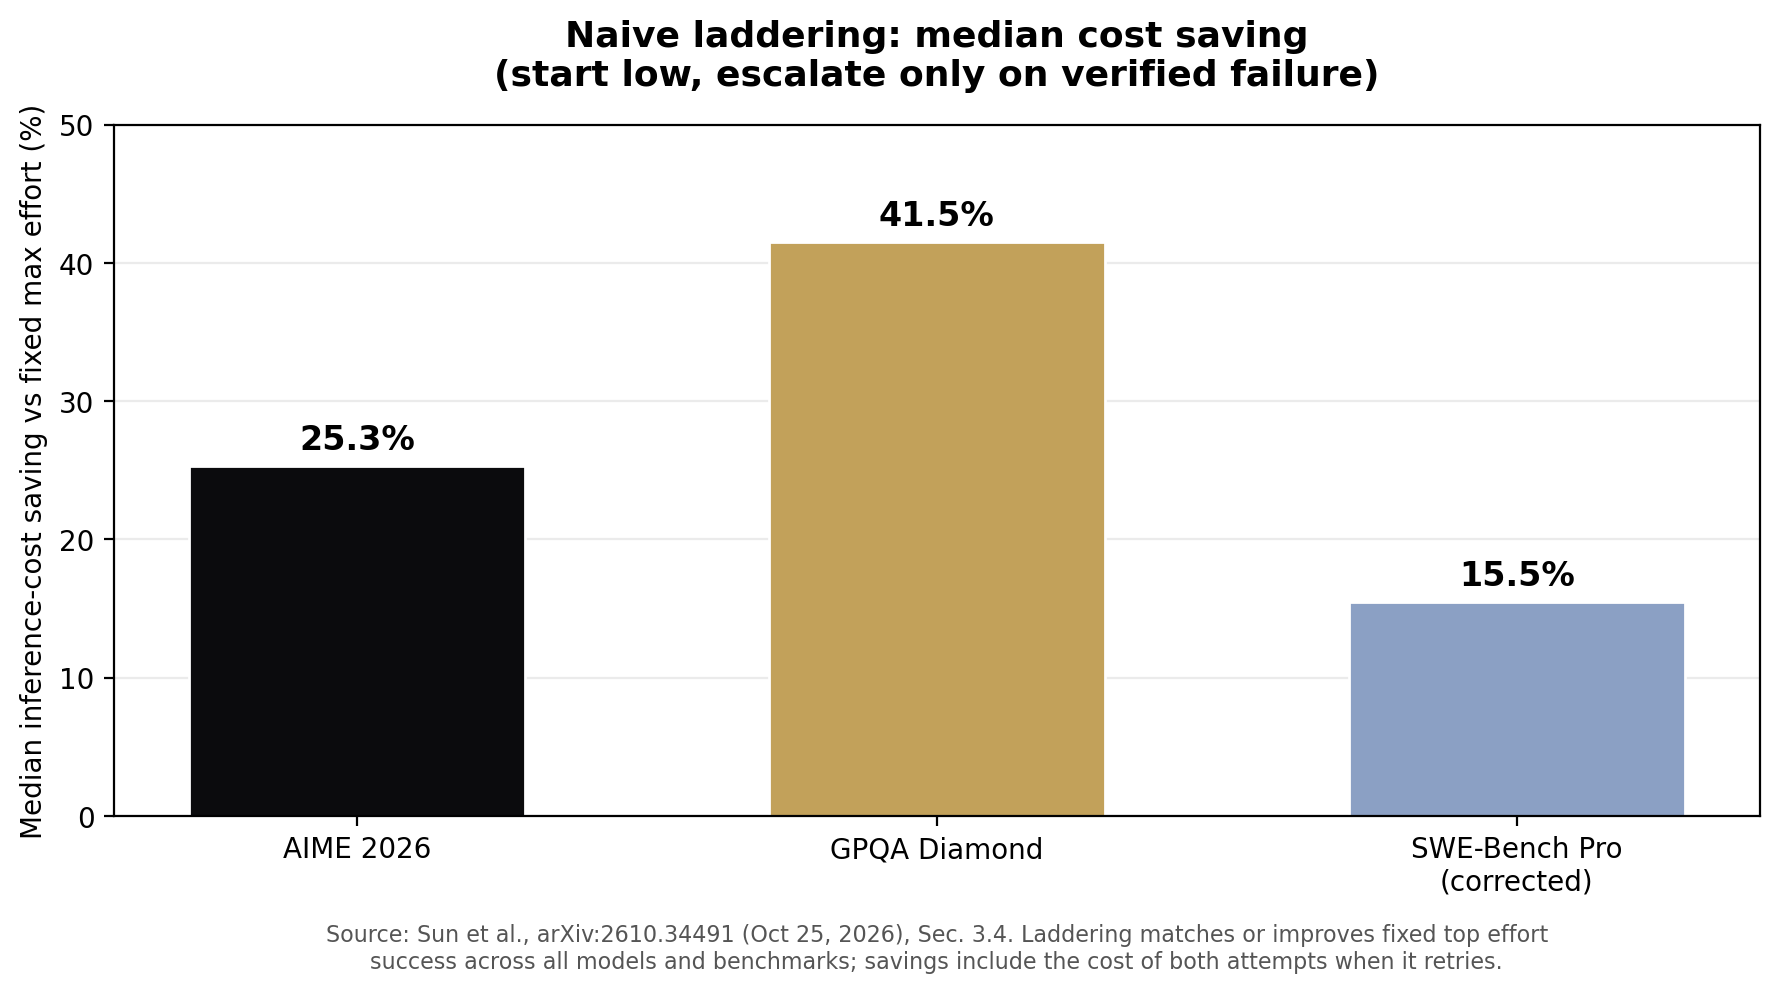
Naive laddering 有效:从最低强度开始,只有在外部验证失败后才用最高强度重试。你保留了所有初始成功,从不在低强度已解的任务上花高强度的钱,只在升级时为两次执行付费。
与固定最高强度相比(已计入重试的两次成本):
- 跨模型的中位推理成本节省:AIME 25.3%,GPQA 41.5%,修正后的 SWE-Bench Pro 15.5%。
- Terminal-Bench 上,8 个模型成功率全部提升。GPT-5.6-sol:83.0% 升到 88.6%,成本降 17.4%;Claude Sonnet 5:76.1% 升到 83.0%,成本降 8.7%;Kimi K3:73.0% 升到 84.3%,成本降 30.5%。其余 4 个模型成功率提升但成本上升——分层升级不是处处免费,但从未在成功率上输。
- 计入用户等待时间(论文按美国平均时薪 33.54 美元估算),优势更大:GPT-5.6-terra 在 Terminal-Bench 上总成本省 19.5%,而只看 API 账单只省 4.8%,因为在该分析中等待时间占总成本的 80% 以上。
坦白说清的局限
- 由于预算限制,每个 agent 任务每个强度只跑一次,个别反转包含采样噪声。作者的四次 rollout 消融实验表明模式仍然存在,但不要把某一次反转当成确定性规律来引用。
- 分层升级需要可靠的外部正确性检查——测试、验证器、人工关卡。很多部署根本没有这个。没有它,“只在验证失败时升级”就无从谈起,分层升级会退化成猜测。
- 每次升级都要为完整第二次执行付费。它的价值取决于你的失败率和检查质量,不能只抄论文的中位数。
- 论文把推理强度称为“信任品”(credence good):即使一次运行成功了,你也无法知道买的强度是不是必需的。这正是你需要反事实——同一任务的低强度运行——而不只是最高强度下的成功率的原因。
周一可以做的两件事
- 把一条高频 agent 路径的默认值翻过来。 从固定最高/高强度,改成“低强度先行,只在验证失败(测试失败、验证器驳回、人工驳回)时升级”。跑两周,记录成功率、每完成任务成本,以及从未需要升级的任务占比。如果升级任务不到 20%,你以前的最高强度默认值基本就是在白花钱。
- 给评测表加两列:强度列,和回归列。 下一次跑基准时,不要只报每个强度的总准确率,还要报相对低一级强度“新增”和“丢失”的任务,以及全解子集上的成本。任何不展示丢失集合的“强度越高越好”的厂商说法,都是不完整的。如果在你自己的工作负载上,高强度丢失的题比新增的多,那就把它当作回归处理——哪怕它的 headline 数字涨了。
来源
- Sun 等,《What Effort Level Should I Choose? On the Economics of Reasoning Effort in LLM Agents》,arXiv:2610.34491,2026 年 10 月 25 日提交:https://arxiv.org/abs/2610.34491(HTML:https://arxiv.org/html/2610.34491v1)
- 42 倍、回归集、成本数字、检索数字和分层升级节省均出自该论文第 3.1–3.4 节。
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀