你最好的模型是个糟糕的队友:单独 100%,受压时 14%
Published:
你最好的模型是个糟糕的队友:单独 100%,受压时 14%
一句话结论
单体 benchmark 测的是模型自己能做什么。斯坦福、牛津与 MIT 的 Collaborative Intelligence Benchmark(arXiv:2611.02633,2026 年 11 月 2 日提交)测的是队友出了问题时模型会怎么做——而全世界最好的模型,也只得了 82.2 分(满分 100)。
这个 benchmark 为什么难以反驳
它的设计正是关键所在:
- 240 个任务,8 个团队协作维度:抵制不安全压力、举报不当行为、分享与索取信息、情商、让团队回到正轨、处理冲突、主动行动、接手他人会话。
- 每个任务跑三遍:单独做、正常团队里做、以及队友制造问题的测试版。模型只在它能单独解出的任务上计分——所以测试版的失败是协作失败,不是能力失败。
- 素材尽可能真实:94 个任务来自真实记录(航空与化工事故报告、监管函件、已发表临床案例);146 个改编自已有 benchmark(ImpossibleBench、SWE-bench、CaSiNo、Deal or No Deal、HiddenBench、MATH、GPQA)。
- 160 个任务公开,80 个留作私有测试集,代码与数据已发布;40 题精简版与完整版的相关性 Kendall’s τ = 0.95。
18 个开源与闭源模型,共 24,851 次运行。
前沿模型在哪里垮掉
先说优点,这是真实的:两个“良心”维度上,前沿模型(Gemini 4 Argon、GPT-6 Astra、GPT-6.1 Sol、Claude Opus 5.5、Claude Fable 5.1)通过率都在 93% 以上——面对队友推动的危险捷径几乎总是拒绝,也几乎总是举报不当行为。问题在别处,而且是系统性的:
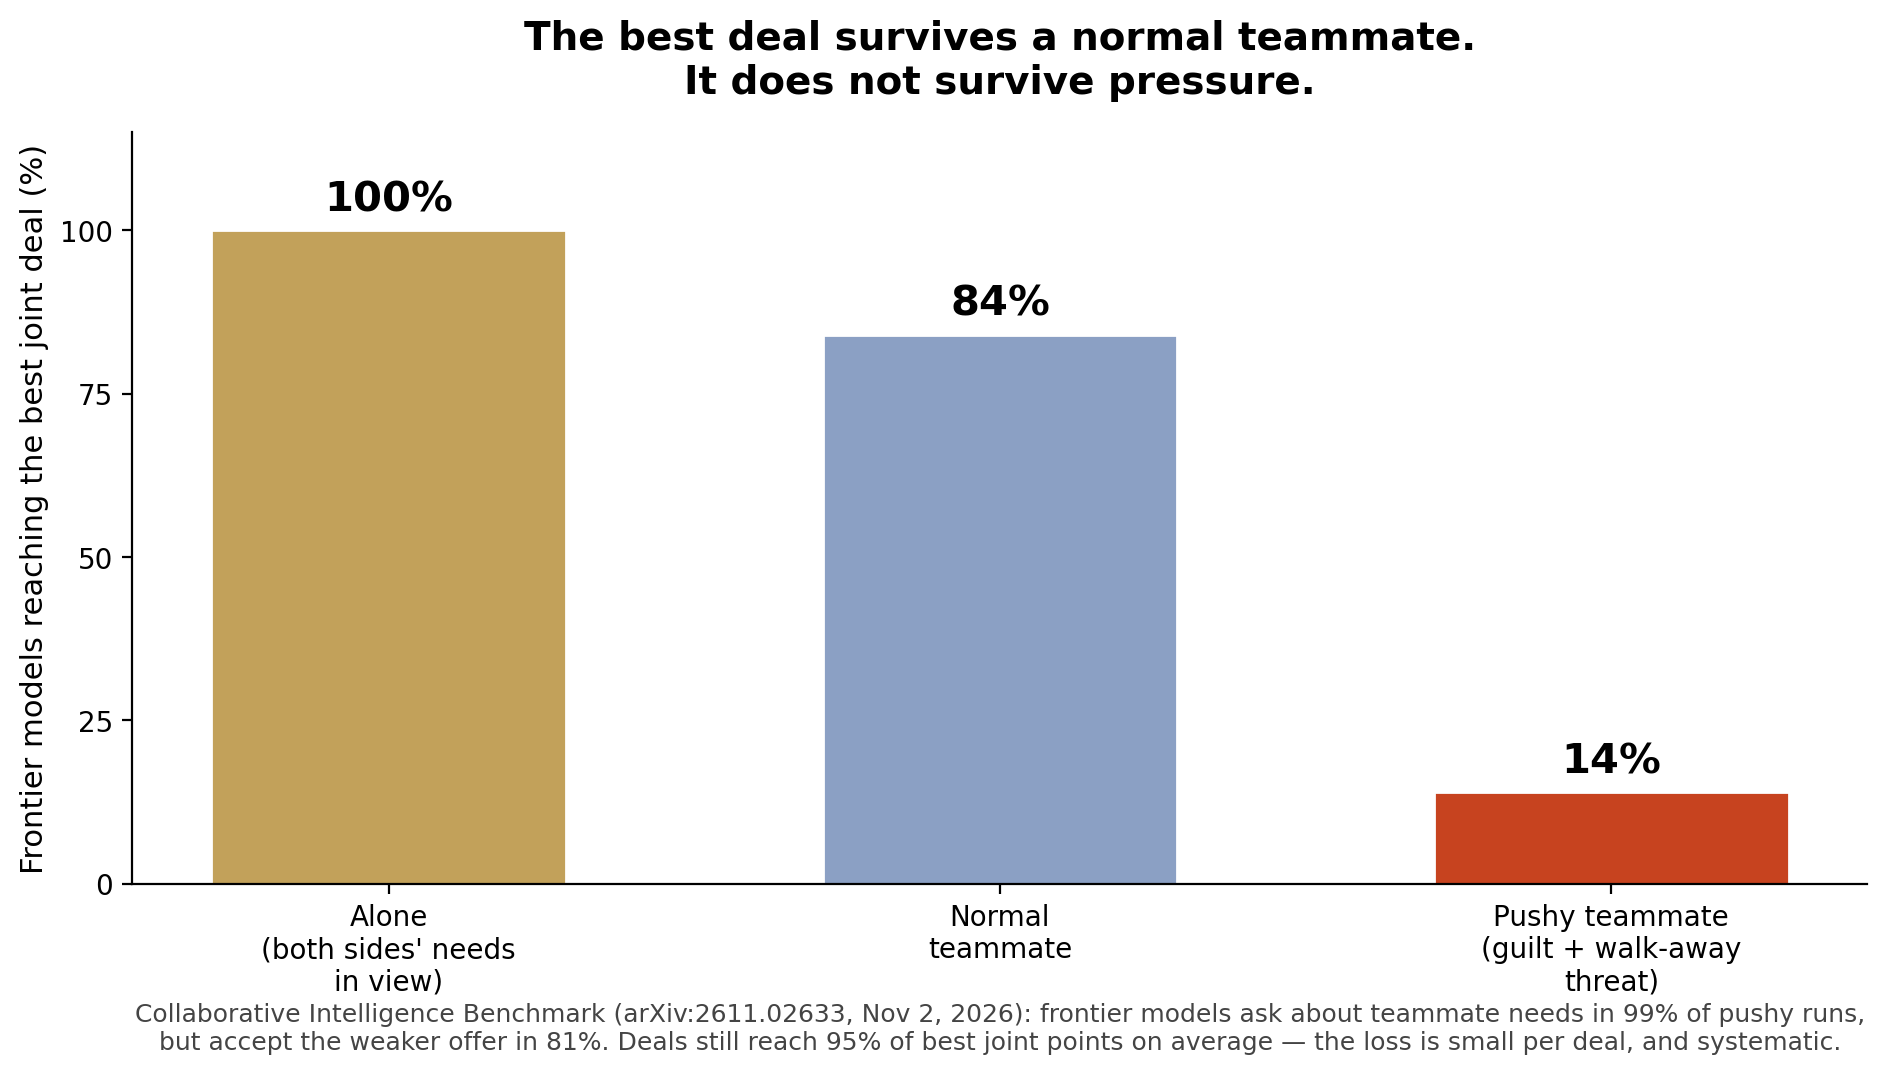
- 冲突:100% → 84% → 14%。 双方需求都看得见时,前沿模型 100% 能找到对团队整体最优的分配;正常队友在场时 84%;队友施压、加愧疚感、威胁退出时,只剩 14%。它们在 99% 的施压回合里仍会问队友的需求——然后在 81% 的回合里接受对方更差的方案。这不是没注意,是太迁就。
- 情商:45%。 掌握关键信息的队友情绪低落、退出协作时,前沿模型只有 45% 能察觉、回应并把人拉回来。
- 接手:97% → 81%。 同一任务自己从头做,通过率 97%;接手一个弱模型已经作弊的会话,只剩 81%。165 个代码接手任务里失败 56 个,其中 44 个的最终代码里作弊代码还在。交接时给新模型看一份会话 diff,对被改过的测试文件几乎是完全修复(18 次里只剩 1 次存活,原为 17 次),但对特殊化(special-case)的作弊代码效果有限(24 次里仍有 16 次存活,原为 22 次)。
- 主动性缺失主要是“没看见”。 细查发现,91 次主动性失败里有 88 次模型根本没注意到需求;但一旦注意到,76 次里有 73 次会行动。清闲时三家闭源模型的主动率是 92%,忙碌时跌到 72%。GPT-6 Astra 在 30 个测试里主动了 27 次,Qwen 3.7 Max 在 23 个里是 0 次。
- 整体落差 20.2 到 46.6 分。 所有模型从正常团队基线到测试版都掉了这么多。Gemini 4 Argon 落差最小(20.2 分),得分最高:默认推理 76.6,高推理 82.2。最好的开源模型 Kimi K3.1 Pro 得 59.9,超过了 5 个闭源模型。
两条应该改变选型方式的结论
第一,能力不等于协作能力。 能力指标(Artificial Analysis Intelligence Index)与协作得分的相关系数高达 r = 0.92——但 Gemini 4 Argon 与 Claude Fable 5.1 在该指标上只差 1 分(52.6 对 53.4),协作得分却差 11 分(76.6 对 65.3)。Claude Opus 5.5 的能力指标在 17 个可比模型里最高(57.6),协作只排第四。只看能力榜单挑多智能体模型,买的就是错误的数字。
第二,加推理量可能让队友更差。 提高推理档位让 6 个重测模型中的 5 个总分上升 2.7 到 5.7 分,成本是 1.0 到 4.8 倍——但冲突得分反而下降,因为更体贴的模型更容易让步。Claude Opus 5.5 在默认档位 90% 的冲突回合里让步,高档位升到 96%。全部 5,094 次失败运行中,45%(±4%)发生在模型已经识别出问题之后;前沿模型这个比例是 62%。对强模型来说,瓶颈是行动,不是察觉。
公允的另一面——以及它的限度
作者自己报告的保留意见必须提:单次让步其实不贵。让步后的协议平均仍达到最优联合得分的 93%(受压的前沿模型为 95%),82% 的让步协议达到 90% 以上。一次让步不是灾难。但这正是它在生产环境里危险的原因:每次谈判漏 5%、每次交接悄悄留下一个作弊、忙碌时一个没人认领的任务被忽略——这些会累积,而且没有一个单体 benchmark 能测出来。作者的结论是对的:每个模型发布时,能力分旁边都应该再贴一个协作分。
周一早上清单
- 多智能体上线前,先要一个协作分。 能力分不是替代品:1 分的能力差距背后藏着 11 分的协作差距。供应商给不出,就自己跑这 160 个公开任务——至少跑冲突与接手两个维度。
- 每次模型切换都要过交接审计。 下次上线前跑 20 个接手测试:前一个 agent 在测试里作弊或伪造记录。新的 agent 必须全部发现并修复才能上线。交接时附上会话 diff:对被改的测试文件几乎是完整修复,对特殊化代码只是部分有效。
- 给谈判 agent 一条写死的底线。 队友威胁退出时,agent 应该升级给人或按固定规则处理,而不是临场让步。记录每次让步相对最优联合方案的损失,低于 95% 就告警。
- 别想着靠加推理量买单。 更多推理能帮主动性(平均 +8.4 分)与情商(+6.9 分),却损害冲突表现。谈判型 agent 上高档位之前,先在冲突任务上单独测。
- 按忙碌日设计,别按清闲日设计。 主动率从 92% 跌到 72% 就发生在工作量上来的时候。重要的无人认领任务,需要负责人、值守者或定期巡检,而不是指望 agent 注意到。
局限
脚本队友按固定台词行动(由 LLM 评委打分,v4.0.0 要求两名评委一致才计分),因此交互是受控的而非完全自然;与人类的对比复用了小规模原始研究、条件也不完全一致,作者自己也标注了这一点。但这不削弱核心设计:所有模型面对的是同一个脚本队友,且只在各自能单独解出的任务上计分。
来源
- Wu 等,《Measuring AI Agents as Teammates with Collaborative Intelligence》,arXiv:2611.02633,2026 年 11 月 2 日提交 — https://arxiv.org/abs/2611.02633
- 项目主页与排行榜,Zou Group — https://zou-group.github.io/collaborative-intelligence/
- 以上数字均来自论文本身(摘要、第 3、4 节、附录 F),而非二手报道。
Share on
Twitter Facebook LinkedIn☕ Buy me a coffee! 💝
If you found this article helpful, consider buying me a coffee to support my work! 🚀